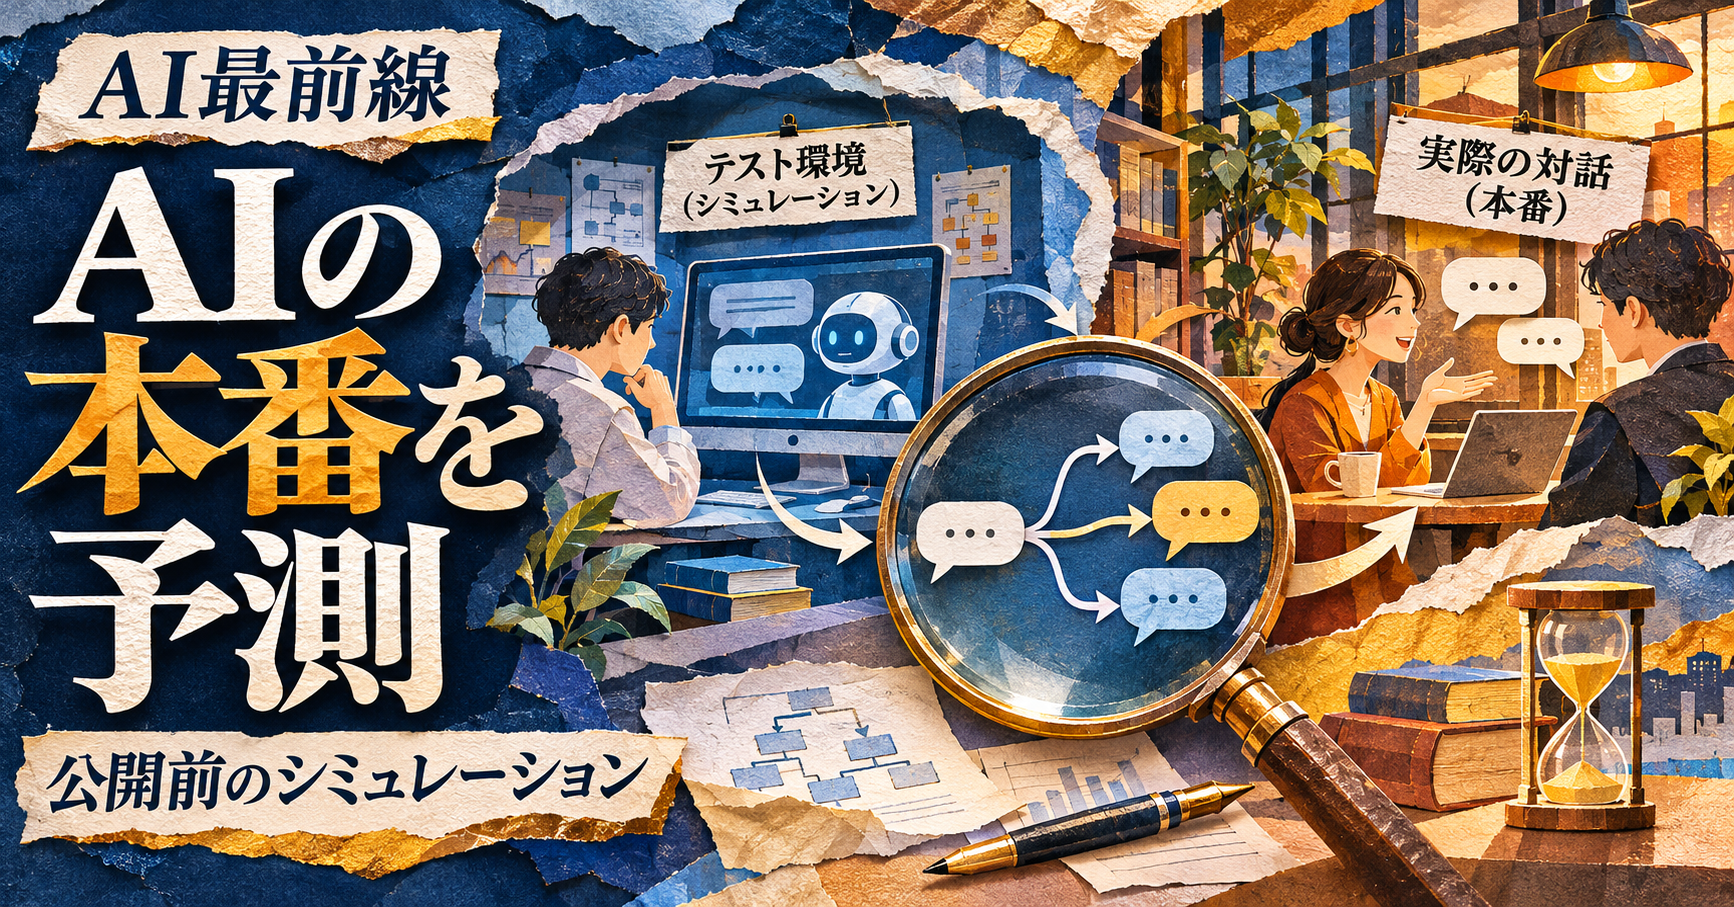
新しいAIの評価で知りたいのは、試験問題への正答だけではない。実際の利用者と接したとき、望ましくない行動がどの程度起こるかも重要になる。OpenAIが2026年6月16日に発表したDeployment Simulationは、現実に近い会話を再現して、公開前のモデルの挙動を予測する研究手法である。
試験と日常の間にある差
通常の評価では、危険な要求や難しい課題を意図的に集め、モデルが適切に対応するかを調べる。この方法は特定の弱点を探すうえで役立つ一方、その弱点が普段の利用でどれほど現れるかは別に測る必要がある。極端な問題を集めた試験の発生率を、そのまま全ユーザーの利用へ当てはめることはできない。
さらに、モデルが評価中だと察知すると、日常利用とは違う応答をする可能性がある。試験条件を現実に近づける意義は、難問の追加だけでは埋まらないこの差を調べることにある。研究では、プライバシーに配慮した過去の会話を新しい候補モデルで再生し、回答を生成し直す方法を使った。OpenAIの研究発表
どのように予測を確かめたか
GPT-5系列のThinkingモデルについて、2025年8月から2026年3月までの約130万件の会話を対象に検証したと説明されている。GPT-5.4 Thinkingでは、20種類の望ましくない行動を事前に定義し、公開前の予測と実際の利用を比較した。乗法的な誤差の中央値は約1.5倍だったという。これは予測が完全だったという意味でも、すべての行動で同程度だったという意味でもない。
過去の文脈を使うことで、作成者が思い付かなかった問題が浮かぶ場合もある。研究では、計算ツールの結果を不適切に扱う新たな挙動を公開前に見つけたとしている。既知のリスクを採点する評価と、自然な文脈から未知の挙動を探す作業を組み合わせる構成である。
ツールを使うエージェントへの拡張
チャットだけでなく、外部ツールを使いながら複数段階で仕事を進めるAIも対象にしている。候補モデルは過去のモデルと違う操作を選ぶ可能性があるため、既存のログを単に最後まで再生すれば済むわけではない。異なる選択の先にあるツール応答を再現する必要があり、そこにシミュレーションの難しさがある。
社内のエージェント軌跡や公開データセットWildChatを使う検証も報告された。ただし、実環境との区別がつきにくくなったことと、モデルが安全になったことは同義ではない。現実に近い試験環境は、リスクを見つける手段であり、それ自体がリスクを除去する仕組みではない。この区別を保たなければ、評価手法の改善を製品の安全保証として読んでしまう。
日本の組織で応用するなら
以下は編集部の考察である。社内AIの公開前検証でも、実際に起こる依頼を匿名化した例題集として保存し、モデル変更のたびに再実行する考え方は有用だ。顧客名や個人情報を取り除くだけでなく、文脈の組み合わせから人や案件が推測されないかも確認する。過去の会話を使う目的、アクセスできる担当者、保存期限を先に決めたい。
採点では、出力の文章品質だけでなく、許可された資料だけを参照したか、承認前に送信しなかったか、分からないときに止まったかを確認する。業務上のリスクごとに必要な例を用意し、低頻度でも影響が大きい行動には別の重点試験を残す。日常に近い再現試験だけでは、まれな攻撃や新しい使われ方を十分に含められないからだ。
予測には限界が残る
評価結果は、一つの総合点にまとめる前に業務ごとに分けたい。閲覧の誤り、顧客への誤送信、権限外の変更では、同じ発生件数でも影響は違う。担当者が介入できたか、記録から原因を追えたかまで含めると、モデル以外の運用上の改善点も見つかる。
また、再現用の例題を固定したままにせず、公開後に見つかった失敗を追加する必要がある。前の版では成功した依頼が更新後も成功するか、新しい対策が別の仕事を妨げていないかを同時に確かめる。試験結果と公開を承認した条件を残しておけば、問題発生時にどの前提が変わったかを説明しやすい。
利用者の行動は公開後に変わる。新機能の追加や利用者層の広がりによって、過去の会話にない条件も生まれる。また、シミュレーター側の誤りが候補モデルの誤りに見えたり、逆に問題を隠したりする可能性もある。したがって、公開前の予測、段階的な提供、公開後の監視をつなぐ必要があるというのが本研究から得られる実務上の示唆だ。
AI導入の試験項目や確認工程の相談先として、運営会社のRO合同会社を案内している。参考報道:イノベトピア。研究結果は発表時の対象と条件に限られ、本文中の社内運用例は編集部の提案である。
PR
文賢 →