反復する仕事の単位で選ぶ
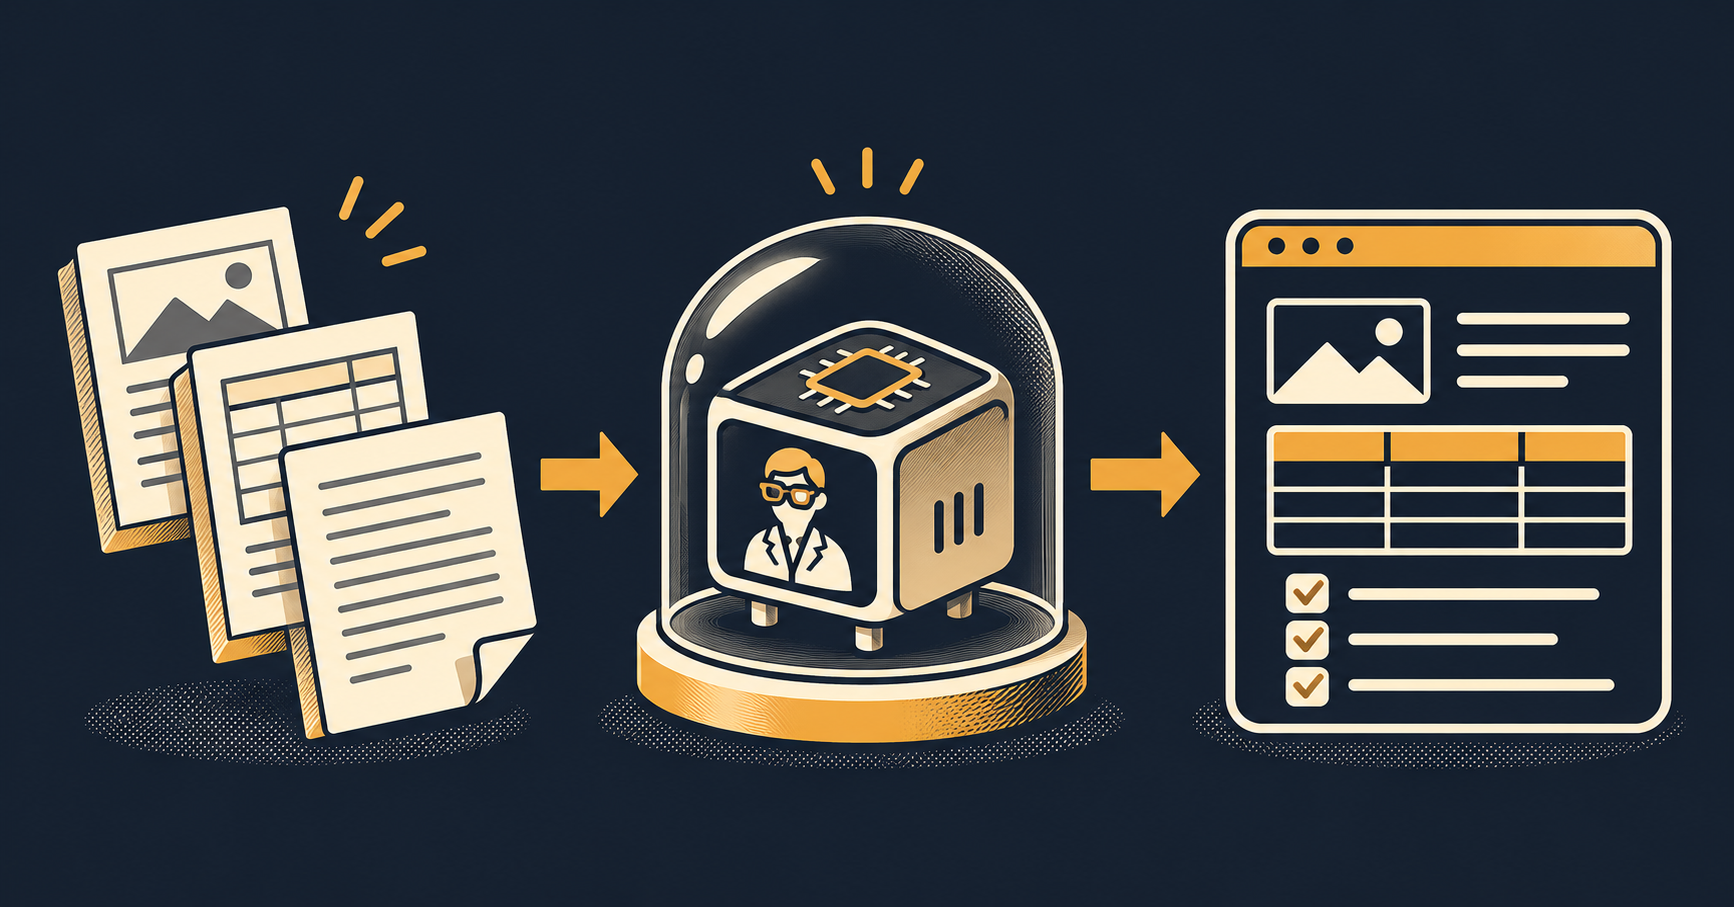
Metaは11月9日、AIエージェントの反復処理に向けた小型モデル「Muse Ember」を発表した。文書から必要な項目を抜き出す、問い合わせの分類先を選ぶ、別のツールに処理を渡すといった用途を想定する。提供元の発表によると、Meta Model APIでは100万トークン当たり入力0.10ドル、出力0.50ドル。これはモデルの入出力単価であり、ツール実行、やり直し、人の確認を含む業務全体の費用は別途見積もる必要がある。
小型モデルに渡す判断を絞る
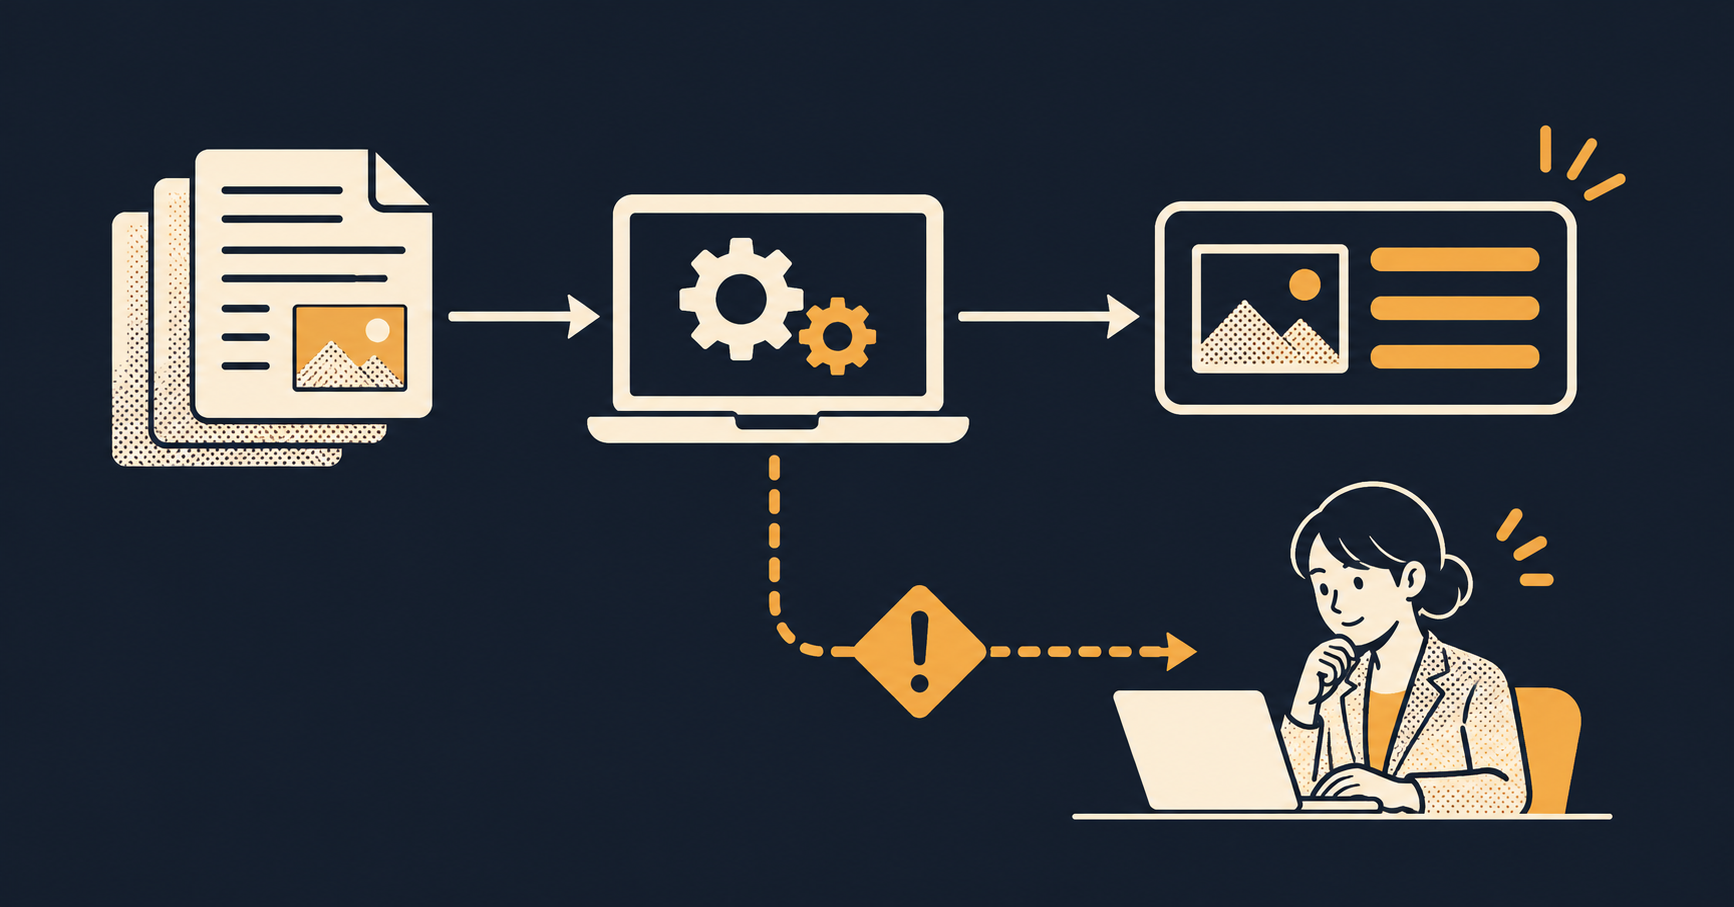
処理の単位を決めるときは、モデルが外した後の行き先から考える。例えば、受注書の分類先が違えば担当者が一覧から拾い直せるが、数量を誤ったまま出荷データを書き換えると訂正の手間が別部署に波及する。分類と確定を別工程にすれば、前者で低単価のモデルを試しながら、後者の承認や監査を維持できる。
開発者向け資料は、Emberに繰り返し発生する処理を割り当て、複雑な計画や仕事全体の進行にMuse WonderやMuse Sparkを組み合わせる構成を示している。画像、音声、動画も入力として扱えるため、資料の形式が違っても同じ工程にまとめる余地がある。ただし、入力を読めることと、個別の書式から必要な項目を毎回正しく拾えることには距離がある。
例えば、小規模な会社で受注書を扱う場合は、品番、数量、納品希望日を抽出し、引用元のページや箇所と一緒に下書きへ出す仕事に絞れる。品番が台帳に見つからない、税込と税抜が混在する、読取箇所が不明といった場合は人に戻す。確定した注文の更新まで任せる場合は、抜き取り精度に加え、例外時に何が記録されて誰に届くかも検証する必要がある。
比較表は自社で試す条件を決めるために使う
Metaが公開した比較では、最大推論設定のEmberは業務フローを扱うAutomationBench-AAでClaude Haiku 5.5とGPT-6 Lunaを上回った。一方、長文書を使うGDP.pdf-AAではGPT-6 Lunaと同点で、ソフトウェア変更の受け入れやすさを見るFrontierCode 2.0-AAではClaude Haiku 5.5が上回った。評価報告では、比較に共通のエージェント実行環境を用いる場合と、個別製品が使う実行環境の違いにも触れている。自社で比較するときは、モデル以外の設定をそろえ、同じ文書と業務ルールで比べたい。
導入先の選択には、処理単価に加えてデータの持ち出し条件も影響する。社内にデータを残す要件がある場合は、ローカルAIの評価で確認すべき点が比較材料になる。外部サービスを使う場合は、機密推論の範囲と保存データの確認で扱ったように、処理中の保護と保存後の管理をそれぞれ確かめる。
最初の検証は書き込みを伴わない一工程で
料金を比べる際は処理した書類数を分母にそろえる。例えば入力2,000・出力300トークンの処理を1,000回行うと、公開単価でのモデル料金は入力0.20ドル、出力0.15ドルで計0.35ドルになる。これは入力と出力を固定した計算例で、キャッシュ、外部ツール、再試行、人手の費用は含まない。レビューに回る件数が増える場合には、モデル料金の差よりも、人が見直す時間の差が導入判断を左右しうる。
判定には通常の正解率に加え「確定に回してはいけない例を却下できた割合」を使うとよい。例えば宛先違い、旧版の帳票、数量の単位違いを混ぜ、誤った確定候補を出した時は自動確定への移行を見送る。モデル名を切り替えた後も同じ評価データを再実行すれば、途中で例外処理が弱くなったか追跡できる。
過去の文書から社外秘を除いた評価用データを用意し、正解となる分類や抽出値を先に記録する。細かい文字、帳票の改版、欄の空白など、人が迷う例も含める。出力の正確さ、保留の妥当性、確認にかかる時間、再実行を含む単価を記録すれば、安さが実際の業務の改善に結びつくかを判断しやすい。機能と評価の記述は公開資料に基づく。APIによる実測値は掲載していない。
運営会社の事業情報は RO合同会社 で確認できる。
PR
ElevenLabs →