原因を探す作業と、設定を変える作業
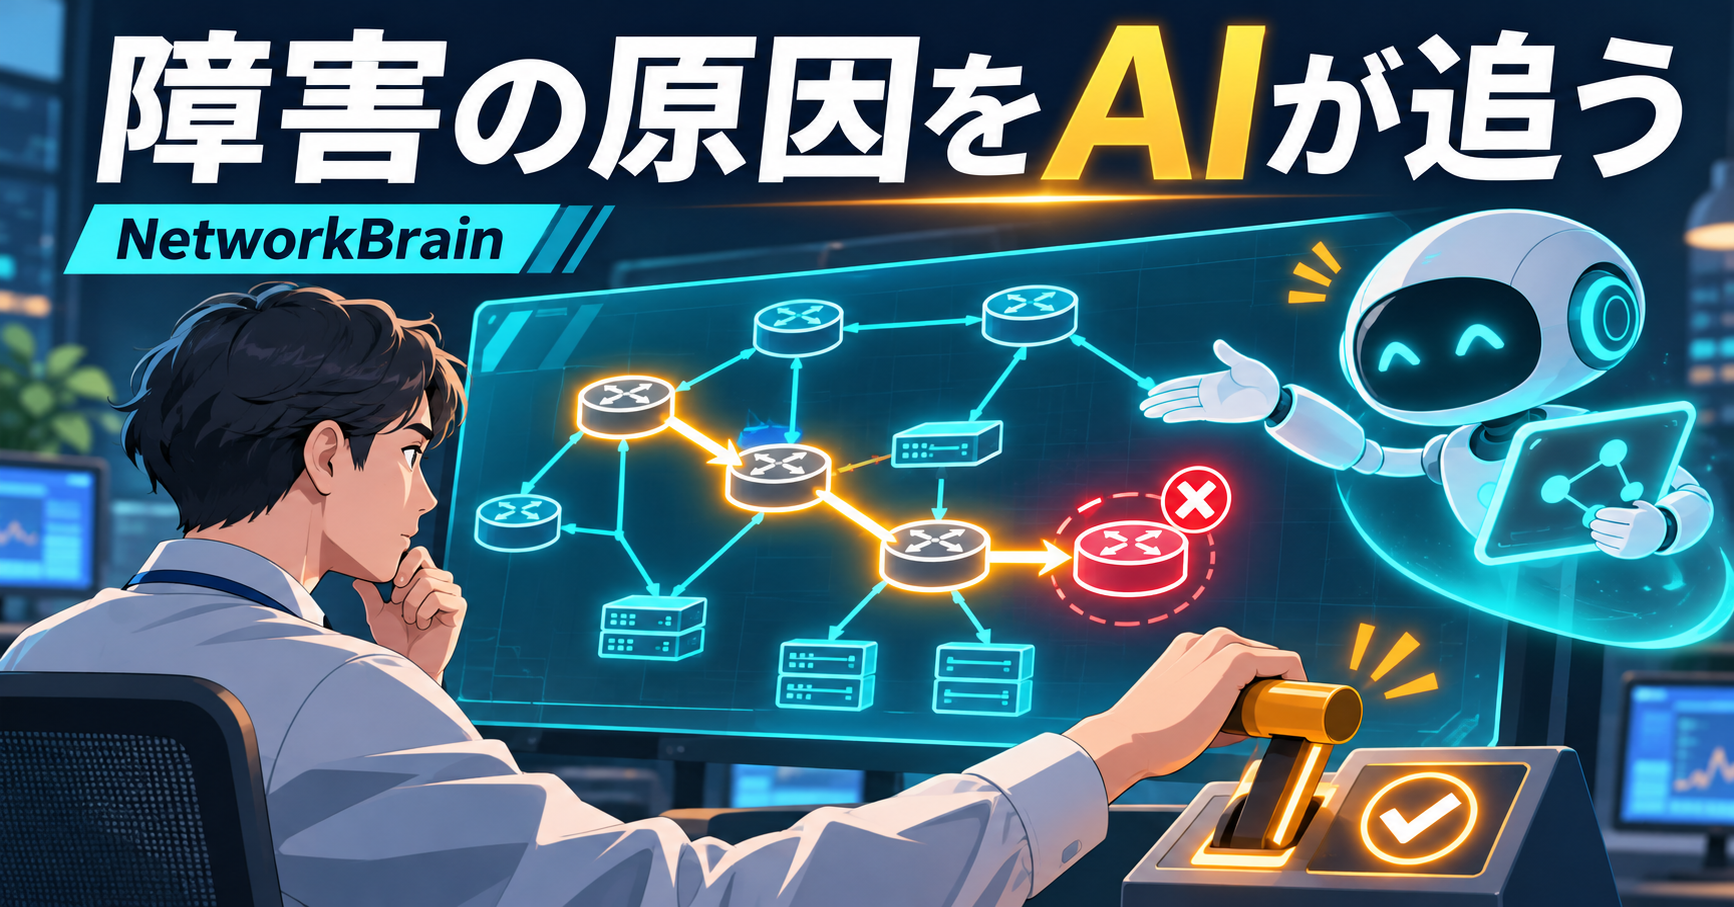
ネットワーク障害では、症状が見えても原因の装置や設定をすぐ特定できるとは限らない。ログの確認、構成の照合、過去の対応記録をたどる作業が必要になる。NTTアドバンステクノロジは2026年6月11日、NetworkBrain R12.3を6月15日から提供すると発表した。AIによる診断と、変更管理を組み合わせた更新として整理できる。
NetworkBrainは、動的なマップを使うネットワーク可視化・自動化の基盤だ。R12.3の発表では四つの機能が挙げられた。Deep Diagnosisは必要な情報収集やコマンド実行、過去データの参照を進め、原因と対応方針を示す。AI Runbook Companionは定義済みの診断フローで集めた情報から次の行動を提案する。Quick Assessmentは複数機器の設定やCLI情報を使う評価を自動化し、Automate Network Changeは異常に対する変更管理タスクを作る。
診断の根拠を確認できるか
Deep Diagnosisの説明では、結論だけでなく判断過程や根拠の可視化も掲げている。現場にとっては、答えが一つ出ることより、その根拠が現在のネットワークを正しく表しているかが重要だ。構成図が古い、収集に失敗した機器がある、監視時刻がずれている、といった条件では診断の前提が崩れる。
運用担当者は、どの機器から、いつ、何を取得した結果かを見たい。AIが提示した原因候補と、実際の観測結果を分けて残せば、誤診時にも調査しやすい。判断理由が長く書かれているだけでは十分でなく、確認可能な記録へ戻れることが必要になる。これは本稿の運用上の考察であり、実環境での性能を測定した結果ではない。
自動化を段階に分けて導入する
発表では設定変更に事前承認フローを組み込めるとしている。診断を自動化したことを、修復を無条件に実行してよい根拠にはできない。原因調査のための読み取り、変更案の作成、承認、実行、変更後の確認を別の工程として管理したい。
例えば、検証環境で診断精度を確認した後、本番環境では変更案までに限定する。対象機器、作業時間帯、影響範囲を人が確認し、実行後には疎通や性能を調べる。戻し方も事前に用意することで、自動化の速さが障害拡大の速さに変わることを防ぎやすい。
Runbookは担当者の経験を再利用する手段になるが、古い手順をそのまま自動化すれば、古い前提も広がる。AIの提案を手順へ追加する際には、実行結果と再利用条件をレビューする。経験の浅い担当者を支援する場合も、例外時に誰へ連絡するかを明確にしておく必要がある。
閉域環境への対応は計画と実装を区別する
NTT-ATは、クラウド接続を必要としないものを含め、主要なLLMを順次サポートする予定と説明している。これは発表当時の方針であり、特定のモデルや構成がすでに利用可能と断定するものではない。閉域網で使うなら、対応モデル、必要な計算資源、ログの保管先、保守時の通信などを個別に確認することになる。
導入評価では、単なる時間短縮に加え、正しい原因へ到達した割合、不要な変更を提案した件数、手動への切り替え時間を記録するとよい。自社の構成と障害の種類を使い、同じ条件で従来手順と比較する。提供元が示す期待効果を、自社でも得られた実績として扱わない姿勢が重要だ。
診断に使った情報を引き継ぐ
障害対応では、担当者の交代時に調査の経緯が失われると、同じ確認を繰り返すことになる。AIの診断も、取得した情報と未確認の範囲を残すことが重要だ。原因が確定したもの、候補にとどまるもの、接続できず調べられなかったものを分ければ、次の担当者が続きから判断しやすい。結論の文章だけを保存する運用では、この区別が抜けやすい。
そのうえで、障害が収束した後は診断と実際の原因を照合し、手順の改善へ戻す。収集するログを増やすことには保管費用や機密情報の管理も伴うため、必要な観測を選ぶ判断が要る。AIの自律性を高めるほど、人が確認できる記録を整える価値も大きくなる。
出典と相談先
NTT-ATの発表、参考報道:イノベトピア。AIによる運用支援の工程・権限設計は、当サイト運営のRO合同会社へご相談いただけます。
AI導入支援AI導入・活用でお悩みなら
AI導入センターに無料相談する →