AIの「できる」と、人が「任せたい」の間を調べる
問い合わせに正しく答えるAIでも、顧客が相談を続けたいと思うとは限らない。文章の誤りを直すだけでは解消しない不安が、仕事の自動化には残る。ライス大学が11月18日に紹介したResponsible Futuresは、この問題を性能向上とは違う角度から調べようとしている。本稿の問いは「中小企業は、どの仕事をAIに任せ、どの場面で人への選択肢を残すべきか」だ。
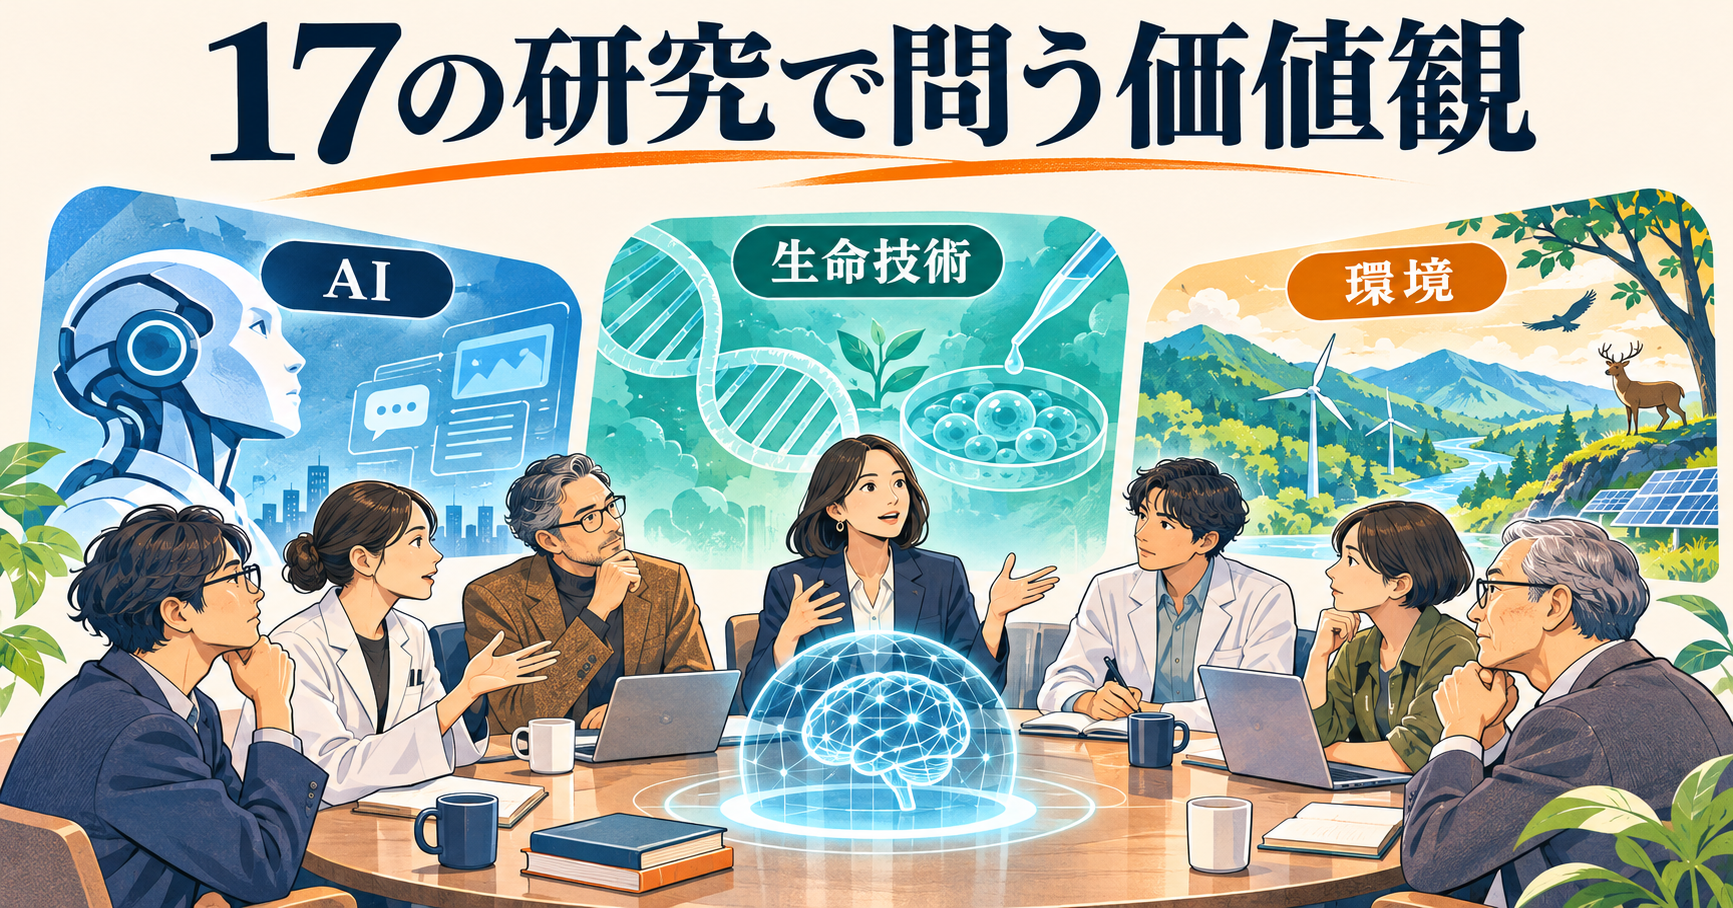
大学の発表によれば、取り組みはBoniuk Instituteとカリフォルニア大学サンディエゴ校が協力し、Templeton Religion Trustの助成を受けて進める。10月23〜24日の会議で始動し、宗教的・精神的・世俗的な価値観と新技術の関係を調べる17の研究を含む。
17件の研究は、AIの性能試験17件という意味ではない
対象はAI、人間に関わる生命技術、自然環境に関わる技術の三領域だ。したがって、この数字を「17件の実験でAIへの不信が証明された」と読むことはできない。新たな研究計画の紹介と、既に結果が出た実験は分けて扱う必要がある。本サイトが以前紹介したライス大学の哲学と工学をつなぐAI教育とも、今回の国際研究計画は区別される。
新しい点は、技術の利用者を単に「操作する人」として扱わないところにある。何を大切にするかによって、同じ自動化を便利とも、関係を損なう変更とも受け取る可能性がある。これは研究計画から読み取れる問題設定であり、特定の国や宗教の人々が一律にAIを拒否するという結論ではない。
ロボット説教者の研究は、どこまで判断材料になるか
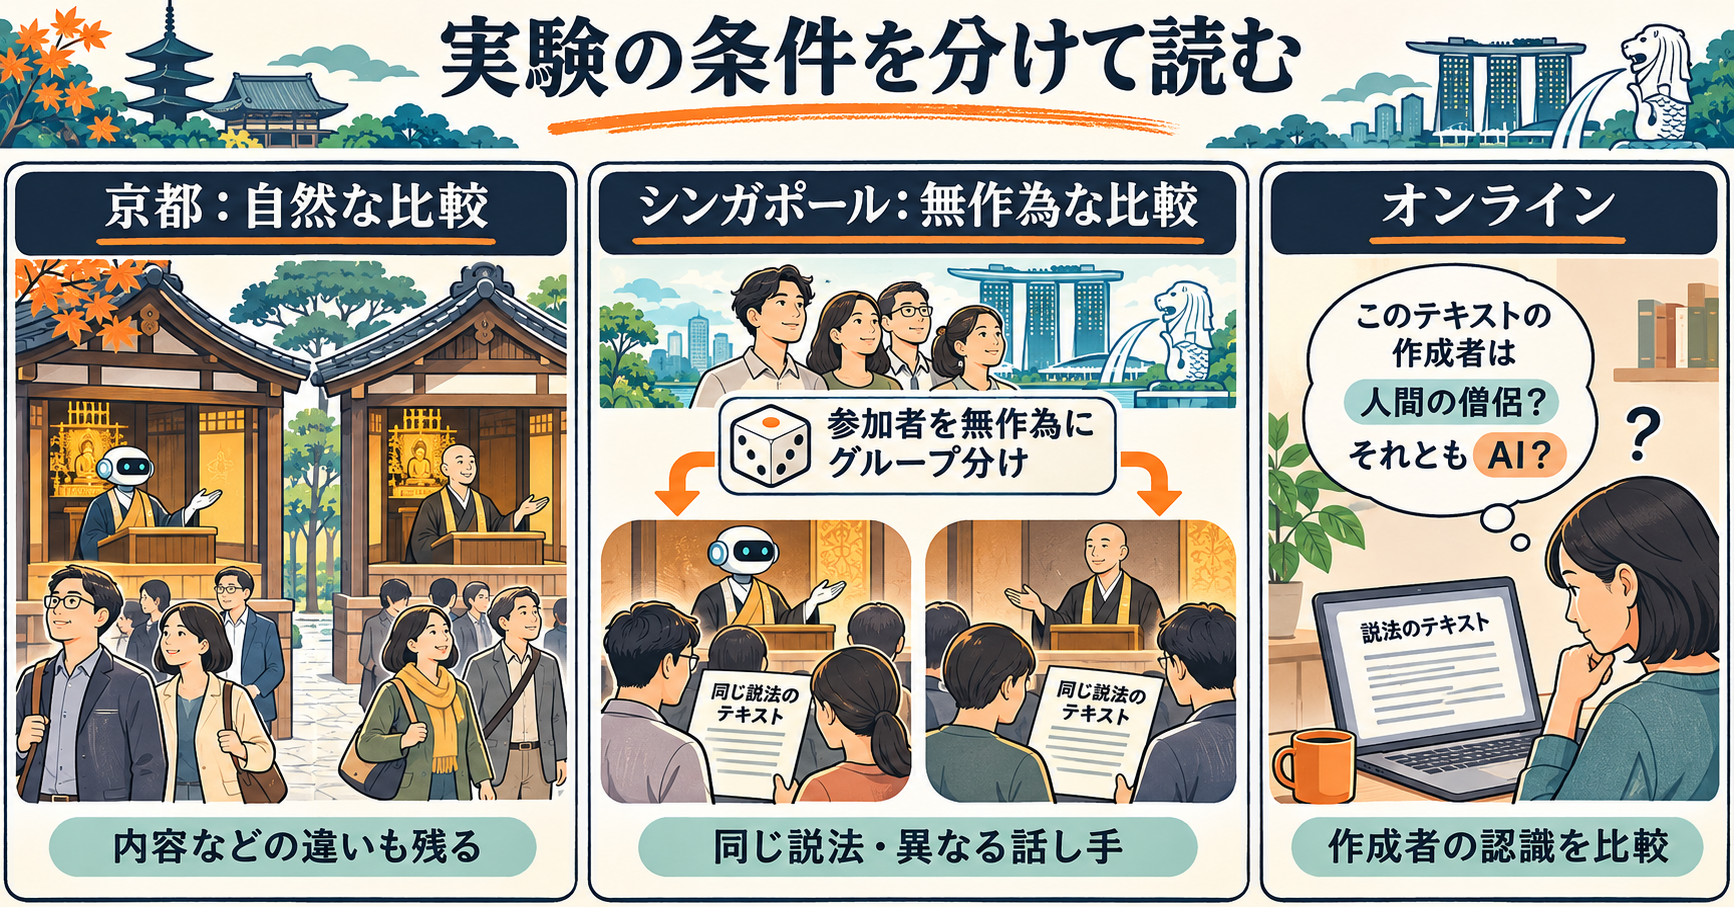
会議では、Joshua Conrad Jacksonらによる過去のロボット説教者研究も紹介された。2023年の原著論文は、京都の寺院での比較、シンガポールの寺院での無作為割り付け、オンライン実験という異なる方法を使っている。単に「ロボットより人が好かれた」という見出しだけでなく、どの条件で何を測ったかに読む価値がある。
自然な比較と無作為な比較では、説明できる範囲が違う
京都の調査は、ロボットと人による説教を見た訪問者を比べたものだが、説教の内容なども異なり、完全な無作為実験ではなかった。一方、シンガポールでは同じ説教を使い、話し手の条件へ参加者を無作為に割り付けた。後者は内容の違いを抑えて話し手の影響を考える助けになる。オンライン実験では、文章の作成者についての認識も調べている。
論文は、これらの条件でロボットの信頼性が人より低く評価され、宗教的な関与の指標にも違いが見られたと報告した。ただし、測ったのは寄付など、研究で定義した指標である。あらゆる信仰の変化を説明する結果でも、現代のチャットAIを使った日本の店舗の売上実験でもない。この境界を超えて「AI受付は顧客を失う」と断定する根拠にはできない。
編集部が実務へ引き寄せるなら、転用すべきなのは効果の大きさではなく、比較の作り方だ。回答文、提示条件、担当者へ戻る方法が同じでなければ、AIか人かの違いだけを評価できない。これは原著の実験設計から導く運用上の考察であり、企業導入での効果を検証した主張ではない。
正答率と受け止められ方を、別の項目として確かめる
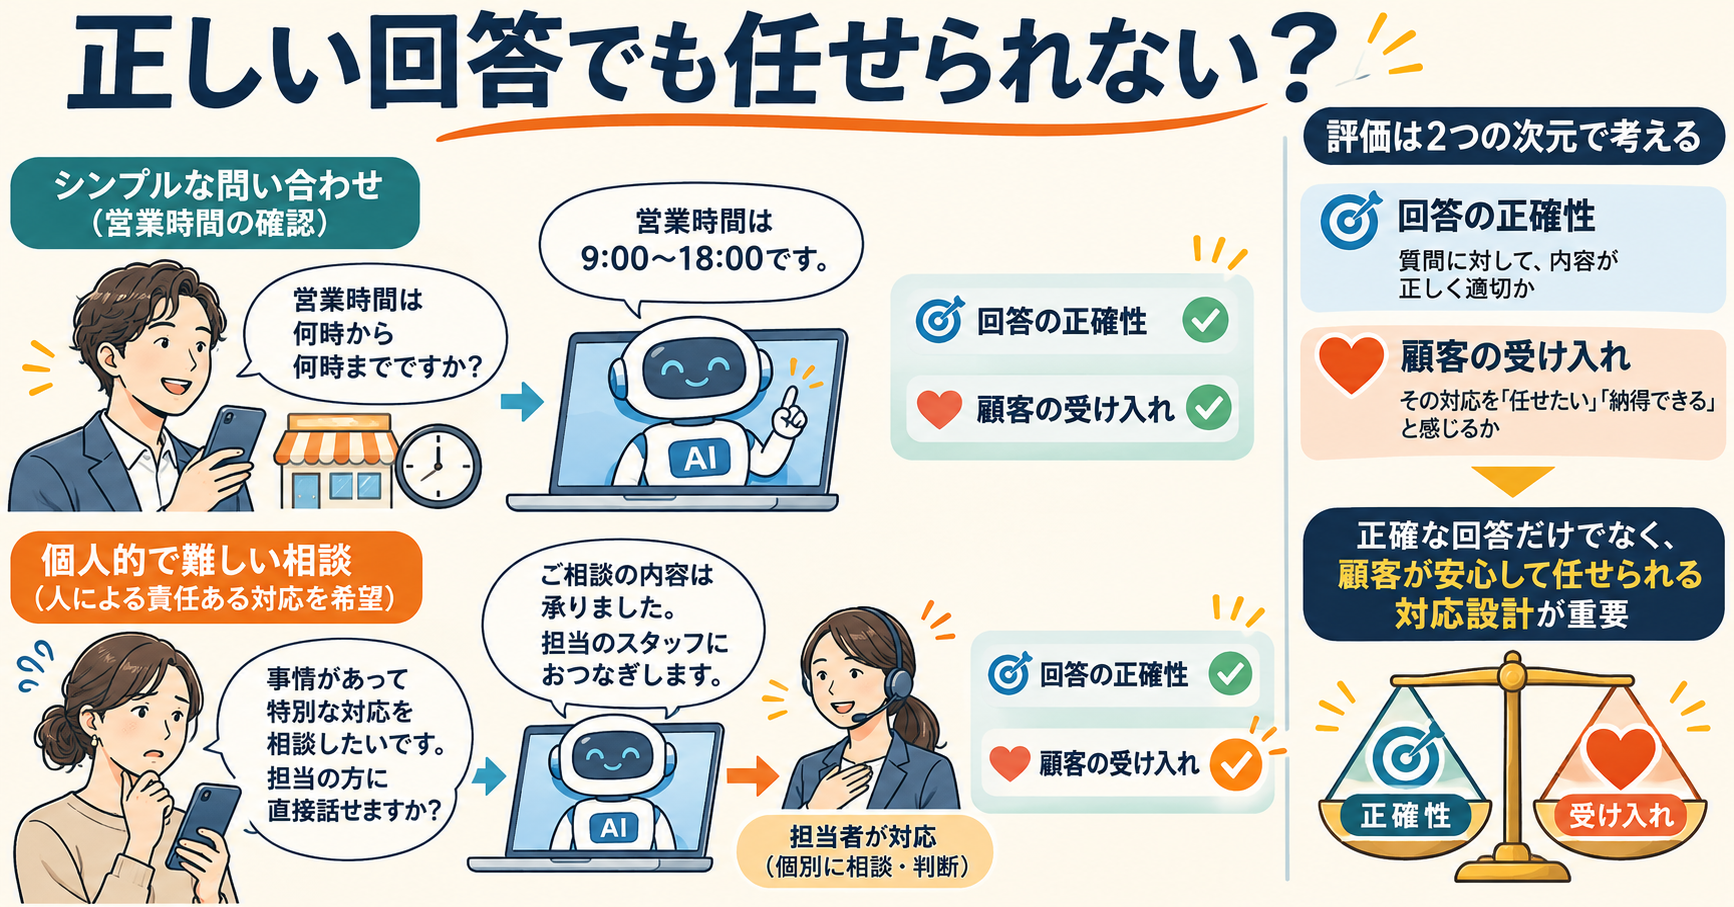
米国NISTのAI RMF 1.0は、用途の文脈と影響を受ける人々を踏まえてAIのリスクを評価する枠組みだ。性能の検証に加えて、利用者などからの問題報告や異議申し立ての経路を評価へ組み込む考え方も示す。これは米国の任意の枠組みであり、日本の中小企業へ一律に新たな法的義務を課す文書ではない。
営業時間の案内と、個別事情を聞く相談を分ける
たとえば、店舗の営業時間を答える仕事では、情報の正しさ、更新日、質問を理解できない場合の対応が中心になる。一方、契約の解約理由や家族の事情を含む相談では、「回答が正しい」に加えて、相手が話す範囲を選べるか、説明を断れるか、責任を持つ人へつながるかが問題になる。この例は編集部が設計したもので、調査対象企業の実例ではない。
同じ文章を返した場合でも、顧客が人との相談を期待していたのに、途中まで自動応答だと分からなかったなら、回答内容とは別の不満が生まれ得る。逆に、定型的な案内をすぐ受け取りたい顧客には、自動対応が便利な場合もある。どちらが多いかは、記事で推測して決めず、自社の利用条件で調べるべきだ。
社内の試験票も二つの欄に分けたい。一方には、参照元の正しさ、欠けた情報を補っていないか、必要な確認が済んだかを書く。もう一方には、AIであると理解できたか、人へ切り替えられたか、同じ事情を何度も説明する負担がなかったかを書く。一つの満足度だけにまとめると、改善すべき場所が見えにくくなる。
人が回答を読んで承認する方式との比較では、速度の測り方にも注意が必要だ。AIの生成が速くても、確認や修正を含む対応全体が長ければ、現場の効率は改善していない可能性がある。これは検証の観点であり、本稿では自社製品や特定サービスの短縮率を測定していない。
試験の聞き方で、答えを誘導しない
信頼の試験で「便利でしたか」とだけ尋ねれば、正確さや気まずさ、待ち時間などが一つの答えに混ざる。編集部の提案は、実際に起きた場面を特定して尋ねることだ。「人へ変更したいと思った場面はどこか」「説明し直す必要があったか」「回答のどの部分を確かめたかったか」と聞けば、改善を操作や表示へ結びつけやすくなる。
AIと人の対応を比べる場合も、人の担当者だけに補助資料を渡したり、AIだけに難しい案件を割り当てたりしていないかを確認する。検証で違いが出ても、その違いが話し手、情報量、待ち時間のどれに由来するか分からなければ、次の施策を選べない。原著の比較方法を企業へそのまま移すのではなく、条件を揃えるという考え方を使うのである。
顧客の属性を大きく括って「高齢者だから拒否する」「若者だから歓迎する」と決めつけるのも避けたい。本稿で読んだ研究は、そのような接客一般の分類を証明していない。対象業務と本人の希望を確認し、必要な支援へ結びつける方が、推測した人物像で利用方法を固定するより検証可能だ。
人への切り替えを含めて、最小の導入単位を作る
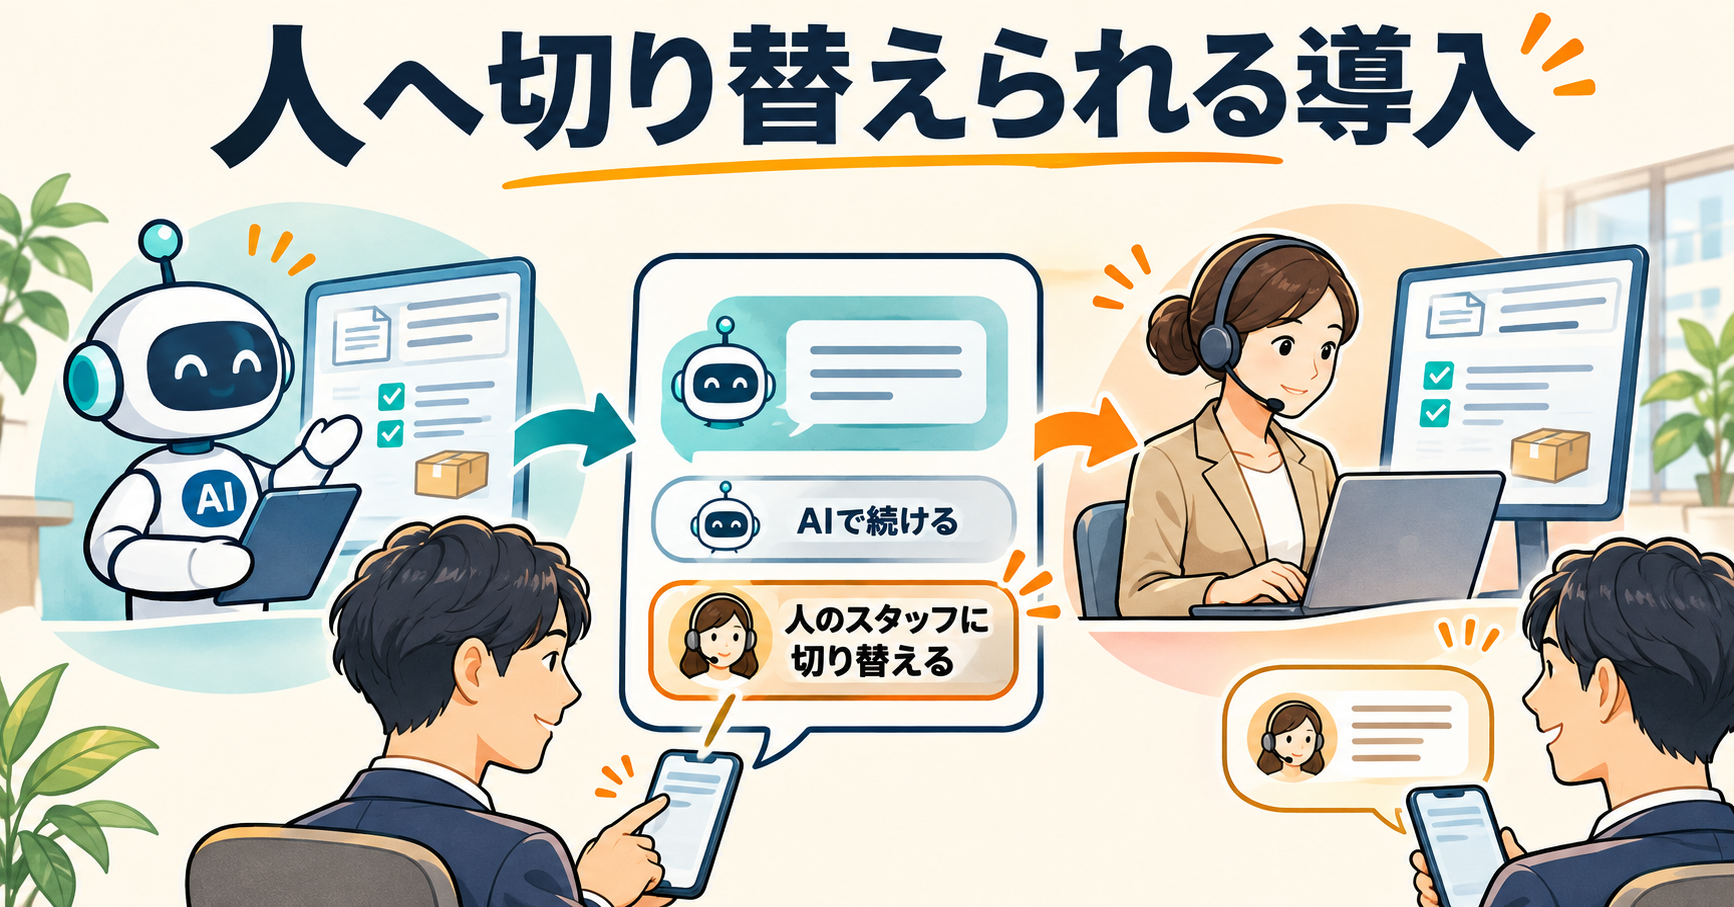
ここからは資料を基にした編集部の提案だ。初めから相談全体をAIに渡すのではなく、必要な情報を探す、説明の下書きを作る、人が判断するために整理する、と仕事を分ける。どの工程ならAIが間違えても外へ出る前に止められるかを探すと、導入範囲を具体化しやすい。
自動化を見送る理由を、失敗として消さない
顧客が人との対応を希望する、判断の根拠を提示できない、引き継ぐ担当者が不在である。こうした条件では、自動完結を見送る選択を残す必要がある。人へ切り替える仕組みが実際にはつながらないなら、画面にボタンがあるだけで対応済みとはいえない。担当者が受け取り、事情を理解し、次の対応を決められるところまで確認する。
検証には実際の顧客の私的な相談を無断で持ち込まず、許可された試験情報を使う。通常の質問に加え、訂正、回答の拒否、人への変更希望も用意する。その結果を見て、AIの回答文を直すのか、対象業務を狭めるのか、人員配置を変えるのかを分けて判断する。モデルの変更だけでは解決しない問題があるからだ。
長期間の運用では、一度の説明で十分とも限らない。画面の変更や担当者の交代で、切り替え先が分かりにくくなる可能性がある。導入時に通った操作を再確認する時期と、苦情を誰が読むかを決めておく。これはNISTの継続的な評価という考え方を、店舗や小規模事業者の運用へ落とした提案である。
AIの内面を推測することと、利用者がどの説明や対応を必要としているかを調べることも違う。AIの意識をめぐる証拠と判断で整理したように、分からない点を人格の断定で埋めるべきではない。ここで必要なのは、顧客の希望を聞き、運用として応えられる範囲を明らかにすることだ。
本稿では原著と研究計画、評価枠組みを照合した。独自の顧客実験は実施しておらず、宗教領域の結果を接客業の効果として流用していない。AI活用の相談先として、運営会社のRO合同会社を案内する。AIを増やすことを成功とせず、任せる理由と任せない理由を説明できる運用を目指したい。
引き継ぎの成否を、担当者の画面で確かめる
たとえば、AIが問い合わせを整理して人へ渡す方式なら、引き継ぎ先に「顧客が何を求めたか」「AIがどこまで答えたか」「未確認の事項」が届くかを見る。相手が言っていない要望を要約に補ってしまえば、人へ切り替えても誤解は残る。引き継ぎ文を短くすることより、確認済みと未確認を区別することが優先される。
また、人への切り替えを選んだ件数が増えても、それだけでAI導入が失敗したとは判断できない。以前は相談を諦めていた人が窓口に届いた可能性と、AIの説明が難しくて切り替えを求めた可能性は違う。理由とその後の対応を確認しなければ、入口の件数だけで成果を測ることになる。切り替えを減らすためにボタンを隠すなら、数字が改善しても顧客の希望に応えたとはいえない。
このように、任せられる範囲を広げる判断には、回答だけでなく、希望が伝わったか、責任のある対応に着地したかという観察が必要になる。Responsible Futuresの研究が今後どの結果を示すかは未確定だが、問いを業務の設計へ落とす作業は、現在の資料からでも始められる。
出典と確認範囲
- Rice University:Responsible Futuresの研究計画(2026年11月18日)。計画の範囲と17件の位置付け。
- Jacksonら:Exposure to Robot Preachers Undermines Religious Commitment(2023年、原著)。実験方法と、その方法で説明できる範囲。
- NIST:AI Risk Management Framework 1.0。用途・影響を受ける人・問題報告を含めた評価。
- 題材の入口:イノベトピア。本稿の企業導入案は編集部の考察。
PR
ElevenLabs →