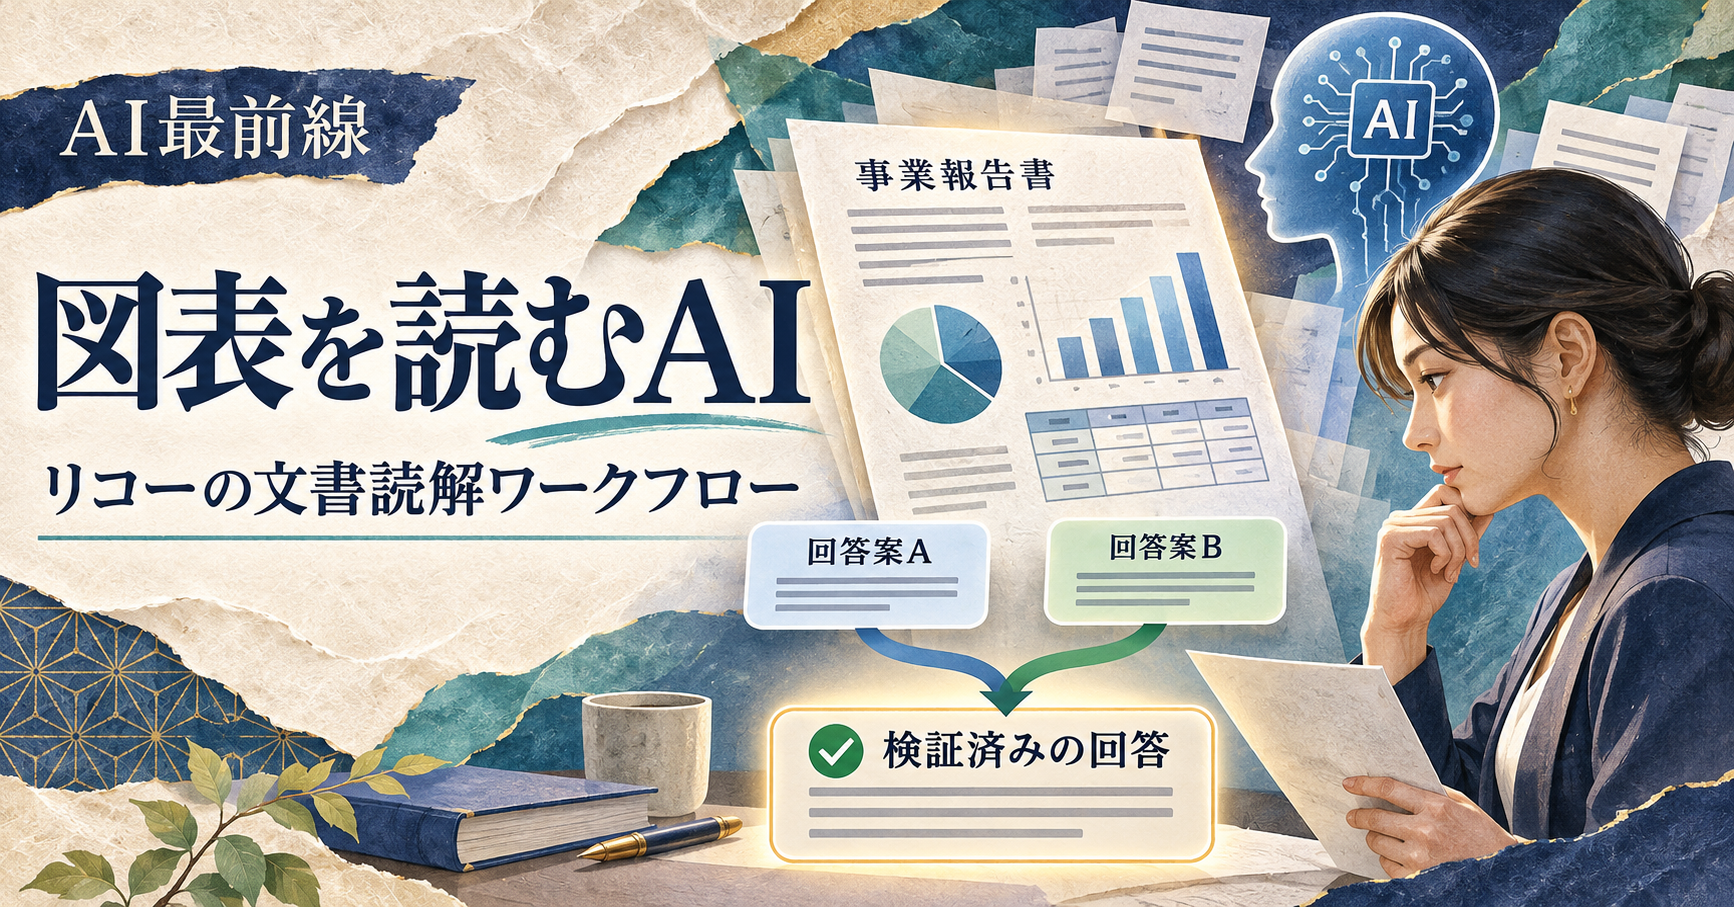
図表を含む社内文書をAIで扱うには、モデルの性能だけでなく、資料の構造をどう渡すかが問われる。リコーが2026年6月17日に公表した文書読解ワークフローは、解析処理と回答候補の統合を組み合わせる提案だ。発表時の評価条件を確かめながら、日本企業での使いどころを考える。
文書を読む前の工程を変える
請求書では金額と項目の対応、経営資料ではグラフの軸や注記、手順書では図と説明の位置関係が意味を持つ。文字を取り出して並べるだけでは、その関係を失うことがある。検索で該当ページへ到達できても、回答に必要な情報が正しく整理されているとは限らない。
今回の仕組みは、テキスト・図・表を文書から抽出する処理と、同じLLMが作った複数の回答候補をまとめるSelf-MoAを使う。モデル自体への追加学習を前提にせず、前後の処理を設計する点が特徴だ。リコーは、DifyのテンプレートとしてオンプレLLMスターターキットへの搭載を当時の夏に予定していた。本記事では発表時の計画を扱っており、個別環境への提供完了を確認したものではない。リコー公式発表
複数回答は何を補うのか
Self-MoAは、複数の異なるモデルを同時に使う方式とは異なり、同一モデルの回答を統合する。読み取り方や推論経路の違いを利用し、単一の応答だけに依存しない構成になる。公式説明では、GPU資源を効率的に活用しながら品質改善を狙うとしている。クラウドと自社環境の双方で使え、組み合わせるLLMを選べるという設計も示された。
ただし、同じモデルが繰り返せば誤りが必ず打ち消されるわけではない。すべての候補が同じ表を取り違えたり、注記を無視したりすれば、統合後も誤る可能性がある。実務では、答えの一致度に加え、原資料のどの領域を根拠にしたかを確認する必要がある。回答候補を増やす回数と処理時間の関係も、自社資料で測る対象になる。
評価値の対象を限定して読む
公式評価はJDocQA Reasoning Benchmarkの単ページ問題1,208件を使い、推論と採点をそれぞれ5回実施した平均値である。二つのリコーモデルで、ワークフロー導入前後のスコアが0.791から0.830、0.875から0.904へ改善した。採点にはLLMによる判定を用いている。全1,362件のうち抽出された範囲であり、長大な複数ページ資料や各社固有の帳票すべてについて性能を保証する数字ではない。
この違いは導入計画に直結する。表を一枚読む仕事と、複数年の報告書を横断して比較する仕事では、必要な仕組みが異なる。高いベンチマーク値をそのまま請求書処理の正答率や工数削減率へ置き換えることはできない。計算の再実行、ページをまたぐ照合、例外の差し戻しなどは別途評価したい。
日本の業務で試す順序
以下は編集部の考察である。最初の実証には、正解と根拠を人が確認できる少量の資料を選ぶとよい。帳票形式、スキャン品質、縦書き、脚注などの種類を分け、誤答を「抽出」「対応付け」「推論」「根拠提示」に分類する。同じ資料に対して解析の有無、候補統合の有無を比較すれば、どの工程が効いたかを判断しやすい。
オンプレミスも、導入しただけで機密管理が完成するわけではない。アクセス権、ログの保存、外部モデルへの接続、文書の削除期限を含めて管理する。人による確認を残す対象は、金額確定や契約判断など業務上の影響から決める。読みやすい回答より、原本に戻って検証できる回答を優先することが、継続利用の土台となる。
継続運用では、資料の書式変更後にも同じ評価を繰り返す必要がある。処理速度、誤読の種類、人が確認した時間を合わせて記録すれば、モデルの入れ替えによる改善と、入力資料の変化による悪化を分けて把握しやすい。
業務の切り分けやAI活用の相談先として、当サイト運営会社のRO合同会社も案内している。
参考報道:イノベトピア。製品構成・評価条件は上記一次資料を確認した。本文の実務への提案は編集部の考察であり、導入成果の実測報告ではない。
PR
文賢 →