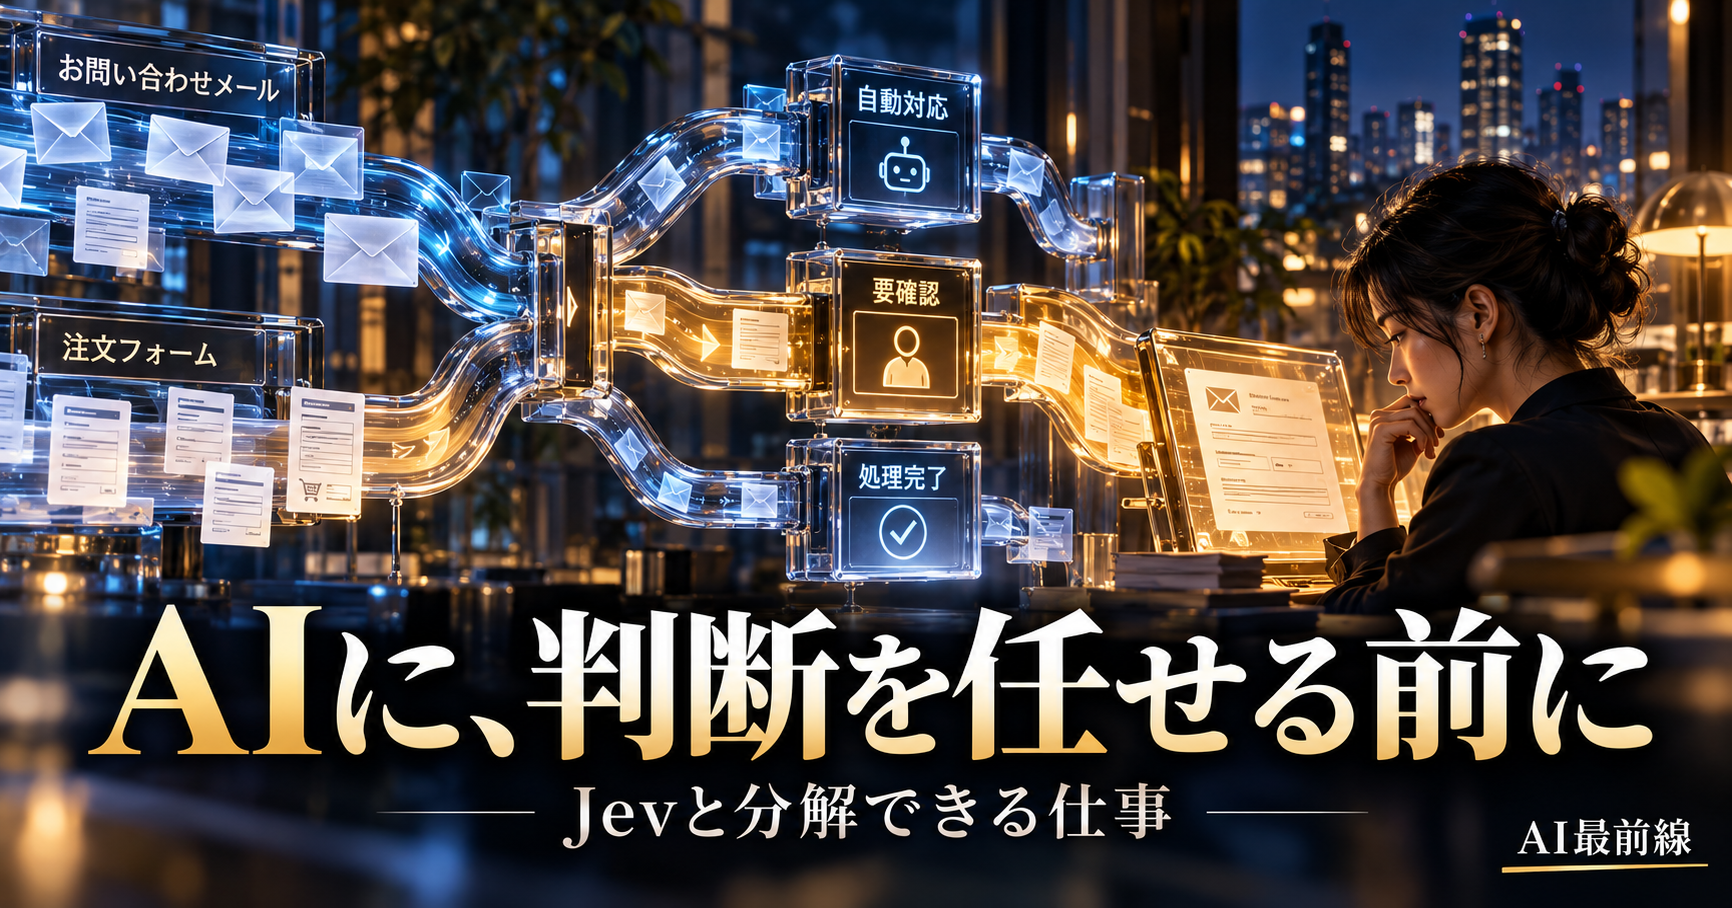
問い合わせの宛先を選ぶ、申請の条件を点検する、文章を分類する。こうした仕事で、ソフトウェアが必要としているのは、流暢な説明文ではなく、次の処理に使える判断であることが多い。TypeSafe AIのJevは、文章を生成する自由度を捨て、あらかじめ決めた型の値と確率を返すことで、その用途に特化するモデルだ。
同社は2026年9月15日、System Oneモデルと呼ぶ仕組みの第一弾としてJevを早期公開した。発表では速度と費用の大幅な改善が強調されたが、注目すべきなのはモデル単体の数字だけではない。判断を細かく分け、決まった計算や分岐をコードへ戻すという、業務の作り方そのものが提案されている。TypeSafe公式発表
テキストを返すのではなく、プログラムが使う値を返す
Jevへの入力は、判断材料であるstateと、答え方を定義した質問で構成する。stateには文章やJSONなどの情報を与える。モデルが自由に返答文を書き、その文からプログラムが結論を抽出するのではなく、最初に定めた形で判定を受け取る設計となる。
質問の型には、ある条件が当てはまる確率を求めるNoul、選択肢から値を選ぶChoice、定めた段階に沿って評価するScoreがある。ChoiceやScoreには分布と確信度も付く。用途によって、振り分け先、優先度、確認の要否などをソフトウェアへ渡せる。
たとえば問い合わせを「請求」「配送」「その他」の三つへ分けるなら、その三つが出力の候補になる。自由な説明文が返ってきて解析に失敗する、定義していない分類名が作られる、といった種類の問題を減らす仕組みだ。ただし、配送の問い合わせを請求と判定する可能性まで消えるわけではない。
この違いは、自動化の責任範囲を考えるうえで重要になる。出力を読み込めること、型が正しいこと、判断が正しいこと、実行してよいことは別の条件だ。Jevが狭めるのは、そのうち出力の形に関する自由度であり、業務上の判断や権限をすべて保証するものではない。
同じ資料に、独立した質問を並べる
公式発表は、同じstateに対して複数の質問を並列に評価する仕組みを説明している。文章を一語ずつ生成するモデルとは違い、定義された判断をまとめて返すことで効率を高める。共通の資料を毎回送り直す必要を減らせる点も、複数の分類や判定を行う業務に向いている。
ただし、複数の質問が独立に評価されることには、設計上の意味がある。質問Bの答えが質問Aの結果を前提とするなら、一度の並列呼び出しだけで、その依存関係まで解決したことにはならない。まず独立に調べられる条件を判定し、その結果をコードで組み合わせるか、必要な場合に次の呼び出しへ渡すことになる。
編集部の考察として、問い合わせ対応なら「請求の話か」「契約の変更を求めているか」「本人確認に必要な情報が不足しているか」を別々に調べる方法がある。最終的な宛先や処理の順序は、その結果と社内のルールから決める。一つの大きな質問に、分類と承認と返信まで詰め込む必要はない。
こうした分解には、テストしやすい利点もある。宛先が間違ったとき、内容の分類を誤ったのか、組み合わせるルールを誤ったのかを切り分けられる。すべてを一つの長いプロンプトへ入れる方式では、どの条件が結果を動かしたか分からなくなりやすい。
高速・低価格の数字は、何を測ったものか
公式の発表価格は入力100万トークンあたり0.042ドルで、出力トークンの料金は無料とされる。応答時間は70〜500ミリ秒という範囲を掲げる。これらは提供元の案内であり、日本の利用環境からの通信や、周辺の前処理、別システムの応答まで含む保証値として読むべきではない。
同社のワークフロー評価は、セキュリティ警報、実行ログの監査、請求書処理、カスタマーサポートなどを扱う。Jevの平均正解率として67.8%、費用0.0004ドル、時間0.4秒という結果が示された。一方、同じ枠組みには、より高い一致率を示す他社モデルもある。最速・最安という話と、すべての判断で最高精度という話は異なる。公式評価サイト
この評価には、正解の定義にも注意が要る。参照に使うのは人が一件ずつ確定したラベルだけではなく、高性能な外部モデルの回答から作る基準だ。したがって、その数字は現実の業務における絶対的な正解率と同じではない。参照モデルの癖や評価を設計した人の選び方も結果へ影響し得る。
公式発表自身も、評価用のワークフローを社内チームが作ったこと、比較の方式による偏りがあることを説明している。デモで大きな差が出たとしても、長い入力、複雑な依存関係、曖昧な日本語の問い合わせで同じ倍率が出るとは限らない。利用者は自分の入力と成功条件で追試する必要がある。
さらに、公式評価では他のモデルも、判断を分解したワークフローを使うほうが、一つのプロンプトにすべてを任せる方式より良い結果を出す。改善のすべてをJevという新モデルだけへ帰属させず、仕事の分け方にも効果があると読むことが大切だ。
型が正しいことと、内容が正しいこと
同社はJevについて、ハルシネーションできないという強い表現を使う。ここで確認すべきなのは、何の誤りを指しているかだ。定義した候補以外の値や壊れた構造を返さないことと、候補の中で必ず正解を選ぶことは同じではない。
たとえば「承認」「保留」「却下」の三択で、保留にすべき申請を承認と返しても、出力の形式は正しい。その形式が正しいまま危険な実行へ進む可能性がある。データ型の検査を省ける部分があっても、金額の計算、権限の確認、承認手続きまで省ける理由にはならない。
公式発表は、グラフ上のハルシネーション率0%について、実測から求めた値ではなくスキーマへの適合の保証に基づく表記であると注記する。この注記を落として「事実を間違えないAI」と紹介すれば、モデルの用途を誤って伝えることになる。
制約された構造の出力自体は、他の生成モデルや推論基盤でも提供されている。Jevの特徴を評価するなら、構造化だけでなく、その判断の速度、費用、確率の較正、実際の業務での安定性まで比較する必要がある。比較対象のモデルも同じ出力条件にそろえることが、公平な検証の前提となる。
確信度を、実行権限に直結させない
確率や確信度が返ることは、人へ戻す判断を作る材料になる。しかし、0.9という数字が出た一件について、必ず90%の確率で正しいと保証されるわけではない。較正は、多数の回答を集めて、予測と実際の結果の対応を見る性質である。用途や入力の分布が変われば、その対応も変わり得る。
実務では、高確信度を自動処理、中間を確認付き、低確信度を人へ回す、といった段階を設けられる。ただし、その境界は業務ごとに測って決める必要がある。ラベルを付けるだけの処理と、返金を確定する処理では、同じ閾値を使う根拠はない。公式資料:Confidence
また、モデルの判断が正しくても、その人が処理を依頼できる権限を持っているかは別の確認だ。問い合わせ文に「管理者です」と書いてあるだけで権限を認めることはできない。認証システムの記録、社内ルール、承認ログをコード側で照合する必要がある。
人へ戻した際に、何を確認してもらうかも重要になる。「AIが自信を持てませんでした」とだけ表示するより、元の資料、該当する規則、判定値、未確認の項目を渡すほうが、確認者が判断しやすい。生成モデルのような説明文を返さない設計だからこそ、周辺システムが示す情報を工夫する必要がある。
公式が示す失敗の形を、テスト項目へ変える
TypeSafeはJev 1.13の弱点を説明するページを公開している。今回確認した版は10月2日レビューで、文字通りの読み過ぎ、計算や数え上げ、日付比較、間接的な参照、無関係な情報の多い入力、敵対的な内容、矛盾した指示、選択肢の順序、生成への不適合を挙げる。Jev 1.13の制約
ここには、何をAIへ渡さないかの指針もある。正確な加算や件数の集計、日付の前後関係はコードで処理する。質問に不要な情報は先に除く。条件に曖昧さがあれば、具体的な境界事例を追加する。AIを使う範囲を狭くすることが、自動化全体の安定性を高める場合がある。
敵対的な入力も、独立した評価対象になる。利用者から届いたメールやフォームには、判定ルールを変えるよう求める文章が含まれる可能性がある。入力を単なるデータとして扱う設計であっても、自然言語の内容が判断を動かし得ることは、公式資料にも注意として示される。正しい形式で返ることだけでは、プロンプトインジェクションへの耐性は確認できない。
選択肢の順番を入れ替えたときに答えが変わらないか、否定形や例外条件で不安定にならないかも確認したい。これらは抽象的な安全性の議論だけでなく、同じ申請を別のテンプレートへ移した際に結果が変わるという、現場で起き得る問題につながる。
現在のモデル名と、9月の評価を分ける
9月の原記事が現行版として扱ったのはJev 1.13だった。10月20日に確認した公式モデル一覧では、10月14日から利用できるJev 1.14も掲載されている。一方、一覧のalias表はjev-latestを1.13、jev-previewを1.14へ向けると説明する。新しい版があることと、既定の名前で呼び出される版が変わったことは、同じではない。公式モデル一覧
この差は、確信度の閾値を調整したシステムで重要になる。版が自動的に変わる名前を使えば、コードを変えていなくても回答の分布が変わり得る。公式資料は、応答のmodelフィールドへ実際の版を記録することや、特定の版で調整した場合にバージョンIDを指定する方法を説明している。
標準の文脈上限も、リクエスト全体と質問ごとの二種類がある。公式一覧では全体64k、stateと各質問の組み合わせ32kとされ、別途の長文設定も案内される。長い入力を受け付ける設定は、短い入力と同じ精度や速度を意味しない。必要な資料だけに絞れるなら、そのほうが検証しやすい。
日本語の業務に適用する場合も、英語のデモの一致率をそのまま採用しない。敬語、主語の省略、部門固有の用語、同じ単語の別の意味などを含む実データで確認する必要がある。誤判定の平均だけでなく、どの種類の誤りを自動処理へ通してしまうかを見ることが大切だ。
公式一覧は、入力がテキストであり、音声や動画を直接受け付けないことも明記する。録音などを使う業務では、文字起こしや構造化を別工程で行う必要があり、その工程の誤りや費用も評価へ含めることになる。
日本語の評価では、間違え方を分類する
たとえば返品の問い合わせを振り分けるなら、単純な「返品したい」だけでなく、「返品したくないが交換したい」「前回は返品した」「返品できるか聞いているだけ」といった例も必要になる。同じ単語が入っていても、現在の依頼は違う。明確な例だけで高い一致率を得ても、実際の運用に必要な条件を測ったことにはならない。
評価用データは、質問を調整するための例と、最後に精度を確かめる例を分ける。失敗例を見ながら基準を直した後、同じ例だけで再評価すれば、その例に合わせた改善を全体の改善と誤認しやすい。新しい部署や別の時期の入力でも結果が保たれるかを見ることで、適用できる範囲を把握しやすくなる。
評価結果では、自動処理へ通した割合と、その中の誤判定率を併記すると実務に結び付きやすい。確認へ戻す件数を増やせば誤りは減らせても、人の負担は増える。精度、処理率、確認時間の三つを並べ、業務として受け入れられる位置を探す必要がある。確信度の境界は、その選択を支える調整値であり、単独で安全性を表す数値ではない。
判断を分けられる業務から、段階的に適用する
最初の対象として考えやすいのは、結果を取り消せて、誤りを測りやすい分類や整理だ。過去の問い合わせへラベルを付け、人の分類と比較する。次に候補の宛先だけを表示し、人が選ぶ工程で使う。十分な検証ができた範囲から自動処理へ進める。これはJevに限らず、判断モデルを業務に組み込む際の進め方になる。
その過程では、入力、質問の版、モデルID、判定値、確信度、人の修正、最終結果を残すと、失敗した条件を探しやすい。モデルに説明文がないからこそ、どの条件で何が起きたかを観測する仕組みが重要となる。速度だけを測って終わらず、確認に必要な情報まで設計する必要がある。
Jevが示すのは、何でも文章で答えるAIとは別の、ソフトウェアへ狭い判断を組み込む方向だ。何を候補にし、何を計算で処理し、どこで人へ戻すかは、導入側が決める。その設計ができて初めて、速度と費用の利点を活かせる。業務の分解やAIエージェントの検証設計については、運営会社のRO合同会社へ相談いただける。
参考報道:イノベトピアの元記事。確認日:2026年10月20日。紹介した性能値は提供元の公表結果であり、本記事の制作でJevやGemini APIは呼び出していない。
PR
ElevenLabs →