「見抜く自信」が下がると、社員の能力も下がったのか
AIで作られた偽情報にだまされないという自信が下がったとき、会社は研修を増やすべきなのか。それとも、情報の確かめ方を見直すべきなのか。本稿の問いは「社員の自己評価と、実際に誤情報を止められる仕事の仕組みを、どう分けて評価するか」だ。意識調査の数字をそのまま能力の低下と読み替えず、判断の過程を測る方法を考える。
NTTドコモ モバイル社会研究所が11月12日に公表した調査では、生成AIを知っている15〜69歳のうち、テキストの偽情報に「自信がある」「やや自信がある」と答えた割合が、2025年の35.4%から2026年の27.6%へ下がった。差は7.8パーセントポイントであり、「3割低下した」という意味ではない。画像と動画でも低下を報告している。
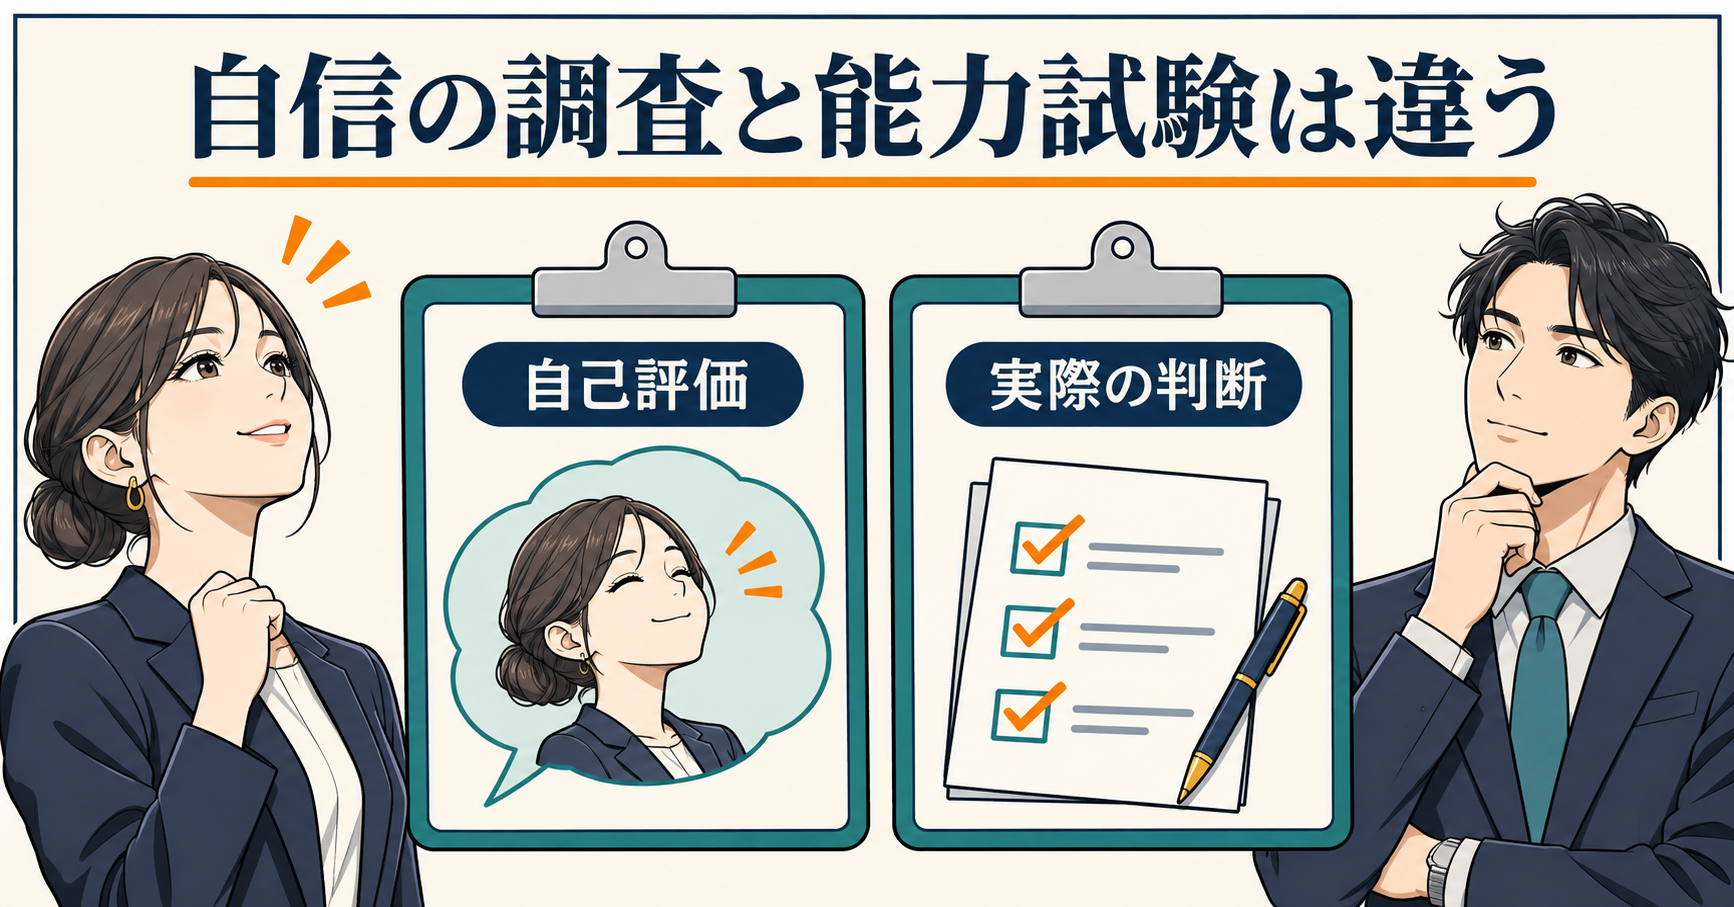
設問が測ったものから、結論の範囲を決める
これは、本物と偽物を提示して正答率を測った試験ではない。自信について尋ねた結果だ。同じ人が同じ問題を解き、以前より正解できなくなったことを示すデータとしては使えない。自信が下がった理由も、この集計だけでは確定しない。生成物の進歩、経験、回答する人の構成など、考えられる要因を一つに決めることはできない。
調査は2025年2月と2026年2月のWeb調査で、有効回答数はそれぞれ7,527人と7,223人。人口構成に基づいて割り当てたオンライン登録パネルから集めている。11月に発表されたから11月の状況を測った、と考えないことも重要だ。社内資料へ引用する際は、公表日と調査時期、対象者と設問を一緒に残したい。
会社の研修でも「自信がありますか」だけを前後で聞けば、似た問題が起きる。学ぶことで難しさを理解し、以前より慎重に答える場合もあり得る。反対に、用語を覚えて自信が増えても、根拠へ戻る行動が身に付いたとは限らない。どちらも本稿の考察であり、今回の調査がその因果関係を証明したという説明ではない。
集計の変化を、人の変化と混同しない
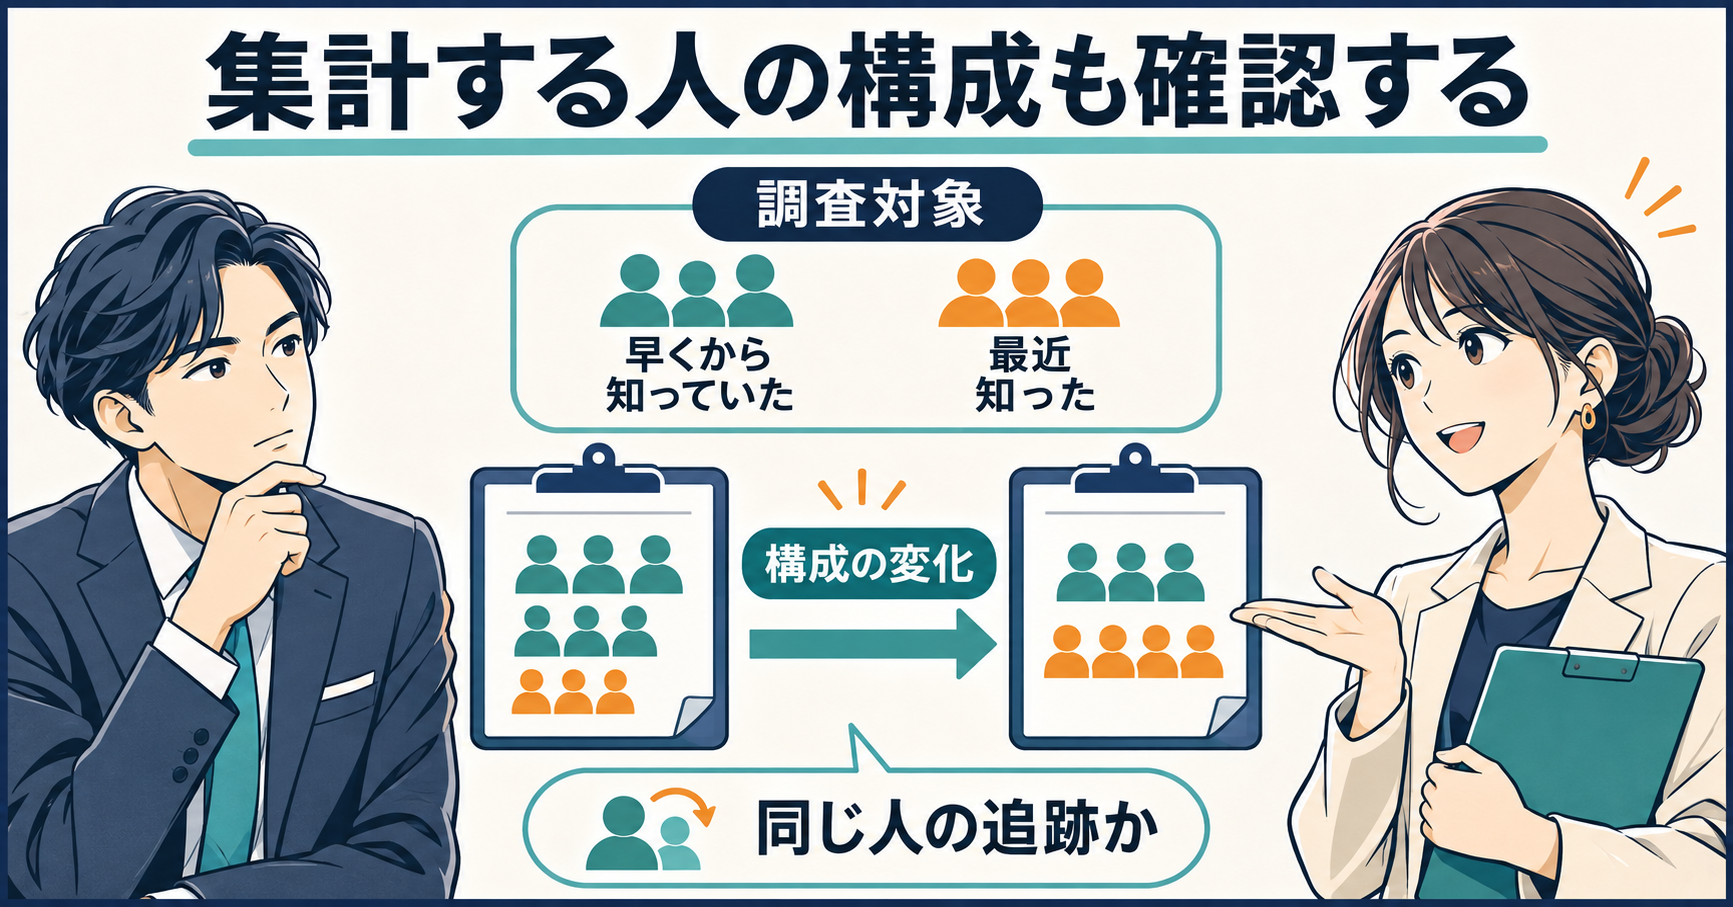
研究所は、生成AIを知っている人が増え、最近知った人が加わったことも割合の低下に関係した可能性を挙げている。ある集団の平均が動いたとき、各人の状態が変わったのか、集団の構成が変わったのかは別の問いになる。年代別などに分けても低下があるため、構成だけですべて説明できたとすることもできない。
架空の二つの集団で、構成の影響を計算する
違いを明確にするため、ここからは実際の調査ではない編集部の架空例を使う。以前からAIを知る集団では40%、最近知った集団では20%が自信ありと答えると仮定する。前者80人、後者20人なら、自信ありは32人と4人で全体36%。前者20人、後者80人に変われば、8人と16人で全体24%になる。
各集団の割合は変えていないのに、全体では12ポイント下がった。これは実際のドコモ調査の内訳を復元した計算ではなく、構成の変化だけでも全体が動くことを示したものだ。現実の変化を説明するには、各集団の人数と割合、集団の中の変化、同じ人を追ったのかどうかを確かめる必要がある。
社内の例なら、昨年はAIに詳しい希望者が研修に参加し、今年は全社員が対象になった場合が考えられる。全体の自信が下がっても、前から参加していた社員の能力が下がったとは限らない。比較には参加条件を揃え、以前からの参加者と新しい参加者を分けるなどの工夫が必要になる。人数の少ない部署の差を、全社の傾向へそのまま広げないことも大切だ。
不満が増えたことも、確認の失敗と同じではない
同じ調査を使った9月24日の別レポートでは、生成AI利用者の不満として「誤情報が含まれている」が34.8%から40.4%へ増えた。こちらの対象は生成AIの利用者であり、11月の自信の設問と完全に同じ集団・同じ問いではない。また、同じ調査系列の別集計を、独立した追試として数えるべきでもない。
不満を言う社員が増えたとき、単に製品に慣れていないと片付けるより、どの仕事でどの誤りを発見したのかを集めた方が改善につながる。取引先名の取り違え、古い価格の引用、存在しない出典は、直す場所が違う。自信や満足度は利用者の状態を知る材料として残し、成果物の正確性とは別の指標として扱いたい。
透かしと来歴を、内容の正しさの判定へ使いすぎない
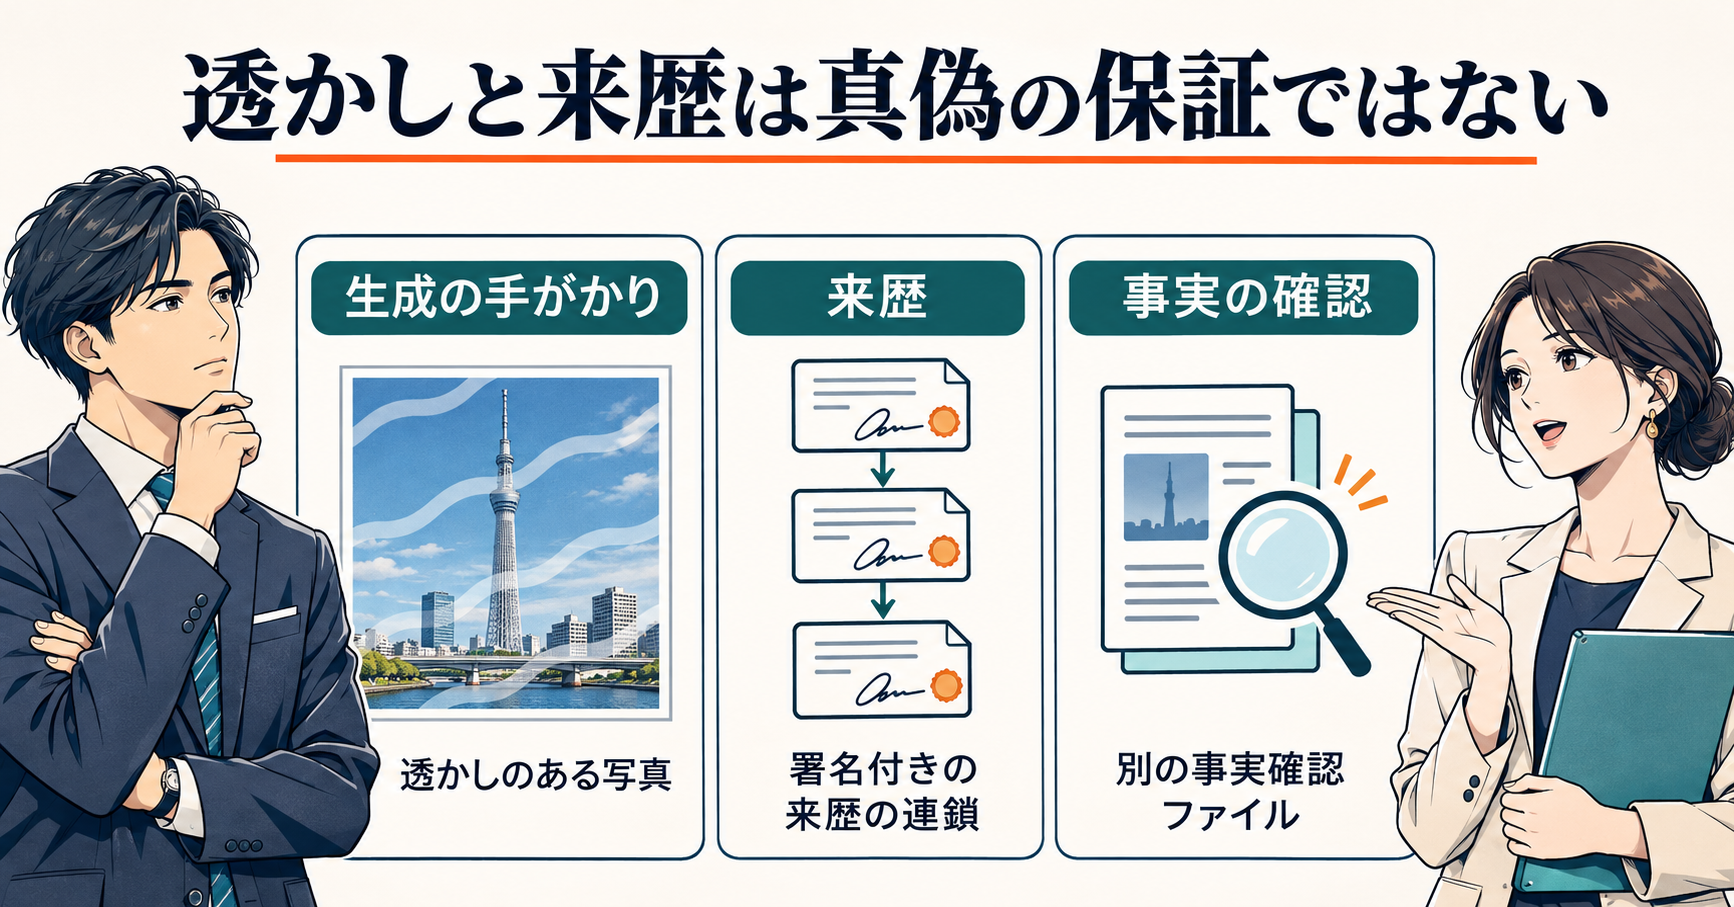
目で見抜く力だけに頼らず、技術的な手がかりを使う方法もある。ただし、その道具が何を確認しているかを理解する必要がある。GoogleのSynthIDの説明は、AIで生成・加工した画像、音声、文章、動画へ見えない透かしを埋め込み、検出する仕組みを示している。調べる中心は生成の手がかりであり、その文章に書かれた出来事の真偽ではない。
「AIで作った」と「うそである」は違う
商品を説明するイラストがAI製でも、商品仕様の説明は正しいかもしれない。反対に、本物の写真に別の日付や場所を付けた投稿は、写真自体が生成物でなくても、読む人を誤解させる。生成を検出する道具と、出来事の確認を一つの判断にまとめると、こうした違いを取りこぼす。
検出されない場合にも注意が必要だ。確認できる透かしがなかったことを、あらゆる生成AIの使用が否定された証拠として扱うべきではない。使う道具の対象と検出条件を確認し、結果をその範囲に限定して読む必要がある。本稿では検出サービスへ画像や社内資料を送る試験は行っていない。説明しているのは公式文書から確認した仕組みと、その使い分けだ。
来歴が確かでも、主張の根拠は別に読む
C2PAのContent Credentials解説は、デジタル素材の起源や編集の履歴を確認するための仕組みを説明する。一方、来歴の情報だけで内容が真実、正確、事実であるかは分からないとも明記している。署名や履歴を、書かれている主張の正しさの証明として使わないことが重要だ。
たとえば製品紹介の画像に編集履歴があれば、どのように作られたかを調べる手がかりになる。しかし、その製品が日本で販売されているか、表示された価格に税や付属品が含まれるかは、別の資料で確かめなければならない。来歴と事実確認を分けると、確認済みと未確認の欄を具体的に作れる。
企業で生成画像を使うなら、作成元や編集の記録を残すことに加え、画像が示す仕様や効果を誰が確認するかを決める。広告表現の正確性、人物や権利の扱い、公開先の条件も別の確認だ。来歴の仕組みを導入したことで、これらの責任が自動的に引き受けられるわけではない。
研修は、自信ではなく「確認できた過程」も評価する
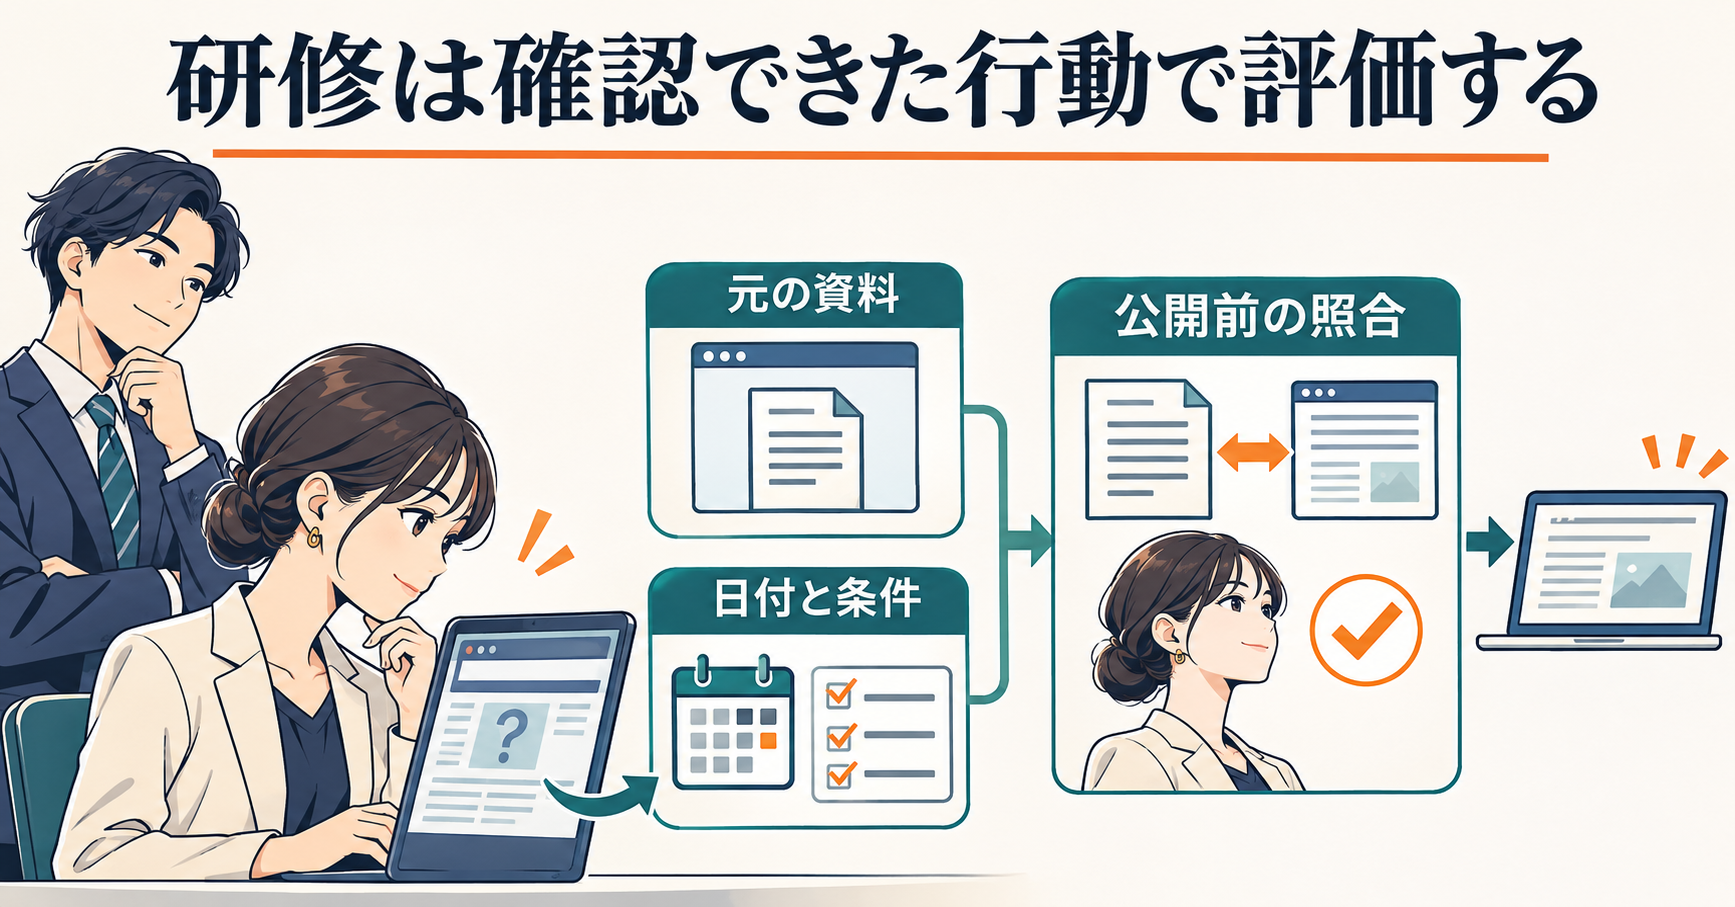
何を教えるべきかを考える資料として、Digital Inquiry Groupが紹介する原研究がある。2022年の研究は、元のページだけを読み込むのではなく、別の情報源へ出て信頼性を調べる「横読み」を教える介入を扱い、授業を受けた生徒のデジタル情報の評価能力に改善を報告した。対象は学校の授業であり、日本の会社の生成AI研修で同じ効果が出ると保証するものではない。
見た目の判定から、根拠へ戻る課題へ変える
ここからは編集部の研修案だ。AIらしい画像を当てるクイズだけでなく、短い業務記事に含まれる価格、日付、機能を、元資料へ戻って確かめる課題を入れる。正解を選んだかに加え、どの資料を使い、どの条件を読み、分からない部分を保留できたかを評価する。検索結果の見出しを見ただけで、元資料を開かなかった場合は区別して記録する。
たとえばAIサービスの導入提案なら、無料試験と通常料金、個人用と法人用、提供中と今後の予定を分ける。Neonの料金を基準日と条件で照合した記事のように、数字が同じでも対象期間が変われば結論が変わる場合がある。研修で覚えてほしいのは「AIを疑う」という態度だけでなく、どの欄を見れば判断を修正できるかという手順だ。
会社名や制度名を含む出典なら、その資料が当事者の発表か、別の記事の引用かも確認する。同じ発表を転載した三つのサイトを見ても、三つの独立した裏付けにはならない。元の発表へ戻り、比較対象には別の原資料を探す。記事を作る担当だけでなく、提案書を確認する担当にも共通する工程になる。
分からないと答えた理由を、評価から落とさない
研修の採点で、どの案件でも断定した人だけを高く評価すると、保留すべき情報まで通す行動を促しかねない。未確認の理由が資料不足なのか、対象範囲の違いなのかを説明できることも評価したい。ただし、何でも保留すればよいのではなく、次に何を調べれば判断できるかまで書く。処理速度と正確性の両方を改善するための記録だ。
前後の比較では、同じ問題を暗記した効果と、別の問題へ手順を適用できた効果を分ける。試験資料、制限時間、閲覧できる資料、採点基準を揃え、正答率だけでなく、根拠へ戻った割合や誤った断定の数を残す。ここで挙げた指標は本稿の提案であり、実施済みの社内研修の成果ではない。
正誤と自信を組にして、次の練習を変える
採点結果は、正解したかと自信の強さを別々に残すと使いやすい。正しく確認できたが自信が低い人には、どの根拠が判断を支えたかを説明する練習が役立つかもしれない。誤った判断を強い自信で通した人には、判断を変えるはずの資料を見落としていないかを確認する。これは研修の設計案であり、今回のドコモ調査から個人の分類を推定したものではない。
誤って本物を偽物と扱うことにも業務上の費用がある。正当な顧客の連絡を止めたり、正しい資料の確認を何度もやり直したりすれば、疑いを強めるだけでは仕事は改善しない。「不明」として保留した案件が、その後に適切な担当へ渡ったかまで追うことで、安全と業務の継続を一緒に評価できる。
仕事の確認点へつながらなければ、研修だけ増やさない
研修で学んでも、実際の仕事に元資料へのリンクがなく、確認の時間も割り当てられていなければ、行動へ移しにくい。AIの性能と信頼を分けた既存記事とも合わせ、成果物のどこに根拠を付け、誰が確認し、更新時にどこを見直すかを仕事の流れへ組み込みたい。
出典を開けない、数字の前提が分からない、権利や公開条件が確認できない場合は、重要な判断や外部公開を見送る。その際は資料不足を記録し、確認先を決める。自信が低いことを直ちに問題とせず、確かめられた範囲を説明できる状態を目指す。運営会社のRO合同会社への相談でも、使うAIの名前より、確認と引き継ぎの工程から整理することが役に立つ。
出典と確認範囲
- モバイル社会研究所:11月12日の自信に関する調査、9月24日の不満に関する別集計:同じ調査系列の一次情報として一群に数えた。能力試験や個人の追跡と読み替えていない。
- Google DeepMind:SynthID:生成・加工の手がかりを調べる仕組み。検出サービスの実測は行っていない。
- C2PA:Content Credentials解説2.3:来歴と内容の真偽の区別。
- Digital Inquiry Group:Lateral Reading on the Open Internet:研究実施者による原研究の紹介。成人の生成AI研修へ効果量を転用していない。
- 題材の入口:イノベトピア:本文の36%・24%は、集団構成の影響を示す編集部の架空例である。
PR
ElevenLabs →