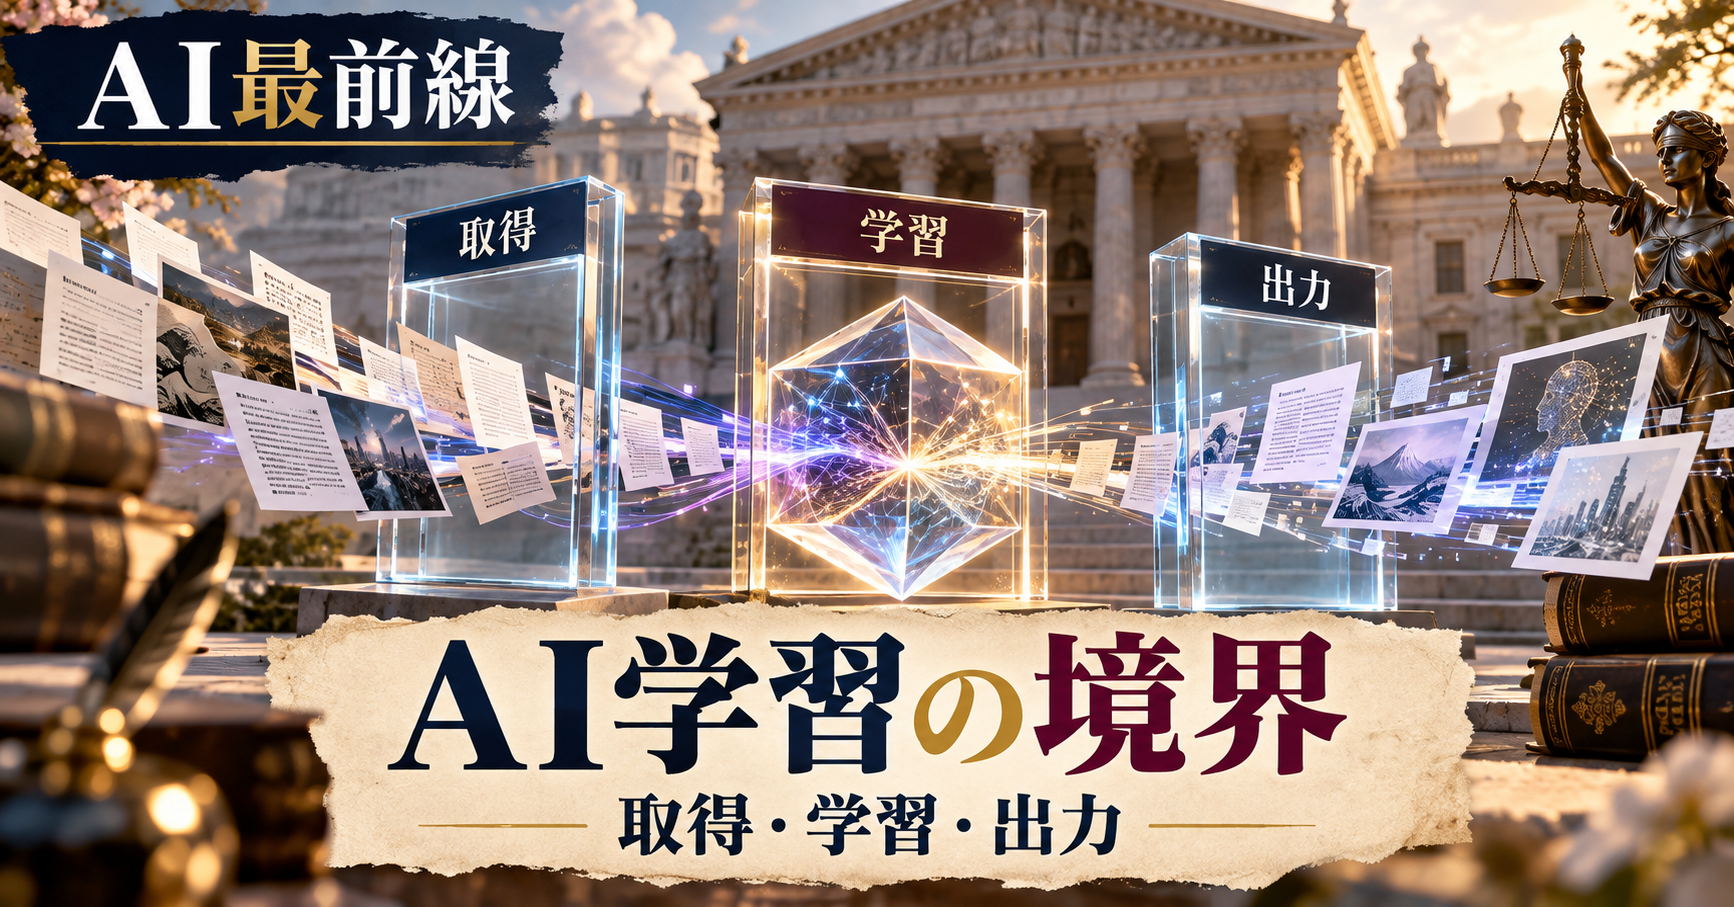
米司法省が2026年9月1日にOpenAIをめぐる著作権訴訟へ提出した意見は、AIの開発全体に免責を与えるものではない。著作物を取得する段階、モデルの学習へ使う段階、利用者へ出力する段階を分け、そのうち学習についてフェアユースを支持する立場を示した。裁判所の結論と政府の主張を区別することが、この書面を読む出発点になる。
政府が提出した意見であり、判決ではない
裁判所提出書面の写しは20ページで、ニューヨーク州南部連邦地裁のOpenAI関連著作権訴訟に関する合衆国の利害関係表明である。司法省は原告・被告としてではなく、28編517条に基づく政府の利害を示すために登場する。
同条を根拠に書面を出せることと、裁判所がその内容に従うことは違う。書面は当事者の主張や既存の判例を論じているが、それによって争点の認定や裁判の結論が確定したわけではない。本稿はこの提出時点の政府の立場を整理するもので、訴訟の最新の進行や個別案件の適法性を断定するものではない。
手続きの名前にも注意したい。政府が自らの利害を表明する書面と、一般に第三者が提出する法廷助言者の意見は、同じものとして扱うべきではない。ニュースを業務上の判断へ使う際は、誰が、どの立場で、何を求めた文書かを先に確かめる必要がある。
三つの処理を一つの合法判断にまとめない
書面が切り分けるのは、データの収集・保存、複製した文章によるモデル学習、入力に応じた文章の出力である。政府は学習を大きな変革性のある利用と位置付ける一方、取得経路や出力で著作物を再構成して頒布する行為について、同じ結論を自動的に及ぼしていない。
例えば、適切に入手した文章から統計的なパターンを学ぶ問題と、無許諾で取得した蔵書を恒常的に保持する問題は、必要な事実が異なる。生成結果が既存の記事や歌詞の代替になる場合には、入力した人や公開する人の行為も関わってくる。モデル学習を支持する書面があることを、取得・蓄積・公開のすべてが認められた根拠にはできない。
この区別は、AIを自社開発しない企業にも関係する。利用許諾を受けたデータか、保存を続けてよいのか、外部AIへ渡せるか、回答を顧客へ再配布してよいかは、それぞれ確認項目になる。契約で許される利用範囲と、著作権法上の評価も同一ではない。
フェアユースの議論はどこに向いているか
米国のフェアユースは、利用の目的と性格、著作物の性質、使われた量と重要性、潜在的な市場への影響という要素から検討される。政府の書面は、モデル学習が元の文章を読み物として提供する利用とは異なることを重視し、市場への影響も区別して論じる。
一方、著作権者にとっては、文章が新しい形で使われても、ライセンスや作品の市場へ影響するなら対価が必要だという問題が残る。書面は一律の学習ライセンスを義務化した場合の競争への影響を論じるが、その産業政策上の見通しが、ただちに裁判上の事実として実証されたわけではない。
利用目的が新しいと主張するだけで、すべての要素が検討済みになるわけでもない。実際のデータ、処理、出力、競合する商品やサービスによって、判断に必要な事実は変わる。企業が社内の資料にまとめる際は、政府が支持する法的な理屈と、まだ争われている事実を別々に書く方が誤解を避けられる。
参入障壁と創作を続ける原資
司法省は、学習に一律のライセンス料を求めると、資金力のある大手だけが開発できる状況につながりかねないと主張する。また、保有作品の多い既存の大手メディアへ利益が偏る可能性も挙げる。これはAI産業の競争条件から見た議論だ。
しかし、作品を作る側の費用と収入も同時に存在する。取材や編集に継続的な支出が必要な事業では、無対価の利用が広がった場合に制作を維持できるかが問題になる。競争を促すこととコンテンツ制作を維持することは、どちらか一方の言葉で片付く課題ではない。
書面は、ライセンスという仕組みそのものが不要だと言い切っていない。出版社が有料記事や最新情報へのアクセスを契約で提供する余地は残る。過去の文章からの学習、現在の情報を取得するサービス、利用者へ記事の内容を渡すサービスを分けると、どこで対価や契約の条件が問題になるかを整理しやすい。
先行事件から結論だけを移さない
政府の書面は先行するAI学習訴訟にも言及するが、裁判ごとに対象の資料、取得経路、請求、提出証拠は違う。ある事件で学習の変革性が認められたことを、別の事件のすべてのデータ取得や出力へ適用することはできない。
とりわけ、複製物をどの目的で保管したかは重要な区別になる。学習の工程に使うための複製と、別の用途にも使える大きな資料庫の維持を、同じ説明で済ませるのは難しい。社内でデータセットを作る場合にも、取得した時点の条件、保存目的、利用部署、削除の基準を追えることが必要になる。
本稿の実務上の考察として、法務・データ管理・開発担当が同じ資料へアクセスできる形で、データの来歴を記録することが有効だ。何を取り込んだか分からないまま、モデルの出力にだけフィルターを置いても、入口の問題は解消しない。逆に取得条件を満たしていても、その後の公開が別の権利を侵害しないかは確認が残る。
日本の制度へ読み替える前に
市場への影響を調べる場合にも、対象を具体的にしたい。学習用データのライセンス市場と、検索結果から記事へ誘導する市場、生成された文章が元記事の購読を代替する市場では、比較する商品も証拠も変わる。単にAIが競合になるという説明だけでも、利用料を取り損ねたという説明だけでも、個別の影響の検討を済ませたことにはならない。
運用面では、同じ資料を学習と検索の両方に使う場合の管理も課題になる。どちらか一方の用途について確認を受けたとしても、もう一方まで許されるとは限らない。データセットの更新やモデルの追加学習のたびに、対象資料と用途の対応を見直す必要がある。処理を一括した「AI利用」という名前で記録すると、その確認が難しくなる。
日本には米国と同じ一般的なフェアユース条項があるわけではなく、著作権法30条の4など、利用目的に応じた規定から検討する。文化庁のAIと著作権に関する公式資料も確認したい。非享受目的の情報解析と、著作物の表現を楽しむ目的の利用は、同じものとして扱えない。
学習段階と生成・利用段階の確認を分けることは、日本の実務にも役立つ。ただし、米司法省の主張を日本法の許可として使うことはできない。どの国で、誰が、どの処理を行い、どの契約が適用されるかを整理した上で、必要な専門家の確認につなぐ必要がある。
例えば、記事の要約を社内検索に使う場合でも、元記事の代わりになる長い文章を外部へ公開する場合とは条件が異なる。外部AIに入力できる範囲と、生成物を顧客へ提供できる範囲も分けたい。利用規約、情報管理、著作権の確認を一つの承認欄でまとめない方が、担当者が判断の根拠を追いやすい。
データの工程を見えるようにする
本稿の考察として、今回の書面を企業が活用するなら、開発や利用を一律に止める・認める材料より、確認事項を分解する材料とするのがよい。取得、前処理、保存、学習、検索、生成、公開の各工程について、目的と責任者を置く。出典や利用条件を残し、必要に応じて対象資料を除外できる運用を用意する。
モデル提供者が示す安全対策も、著作権上の個別の許諾をすべて代行するものではない。生成結果の引用量や出典リンクを点検し、公開に使う文章と社内で確認する文章を分ける。政府の立場が変わっても運用を見直せるよう、判断に用いた資料と確認日を記録しておきたい。
AIによる資料整理や公開前レビューの業務設計は、運営会社RO合同会社の会社情報・相談窓口を参照できる。個別の法的判断は、その案件と法域に応じた専門家へ確認する必要がある。
参考報道:イノベトピア。政府の立場は上記裁判所提出書面、国内制度の確認先は文化庁資料に基づく。業務運用への提案は本稿の考察として記した。
AI導入支援AI導入・活用でお悩みなら
AI導入センターに無料相談する →