GPT-6.2の選択は、任せる仕事と合格条件から始める
OpenAIは2026年11月17日、GPT-6.2 AstraとGPT-6.2 Solを公開した。Astraを難しい専門業務向け、Solを日常の複数工程の仕事を扱うモデルとして位置づけ、APIでも両方を提供する。中小企業が選ぶときの問いは「どちらが一番賢いか」だけでは足りない。同じ仕事を、修正を終えた状態まで何分・いくらで仕上げられるかを比べる必要がある。本稿では公式の発表、価格表、移行ガイド、安全性の報告を照合し、その評価の組み方を整理する。製品の公式発表
書類の抽出と、判断の難しい調査を分ける
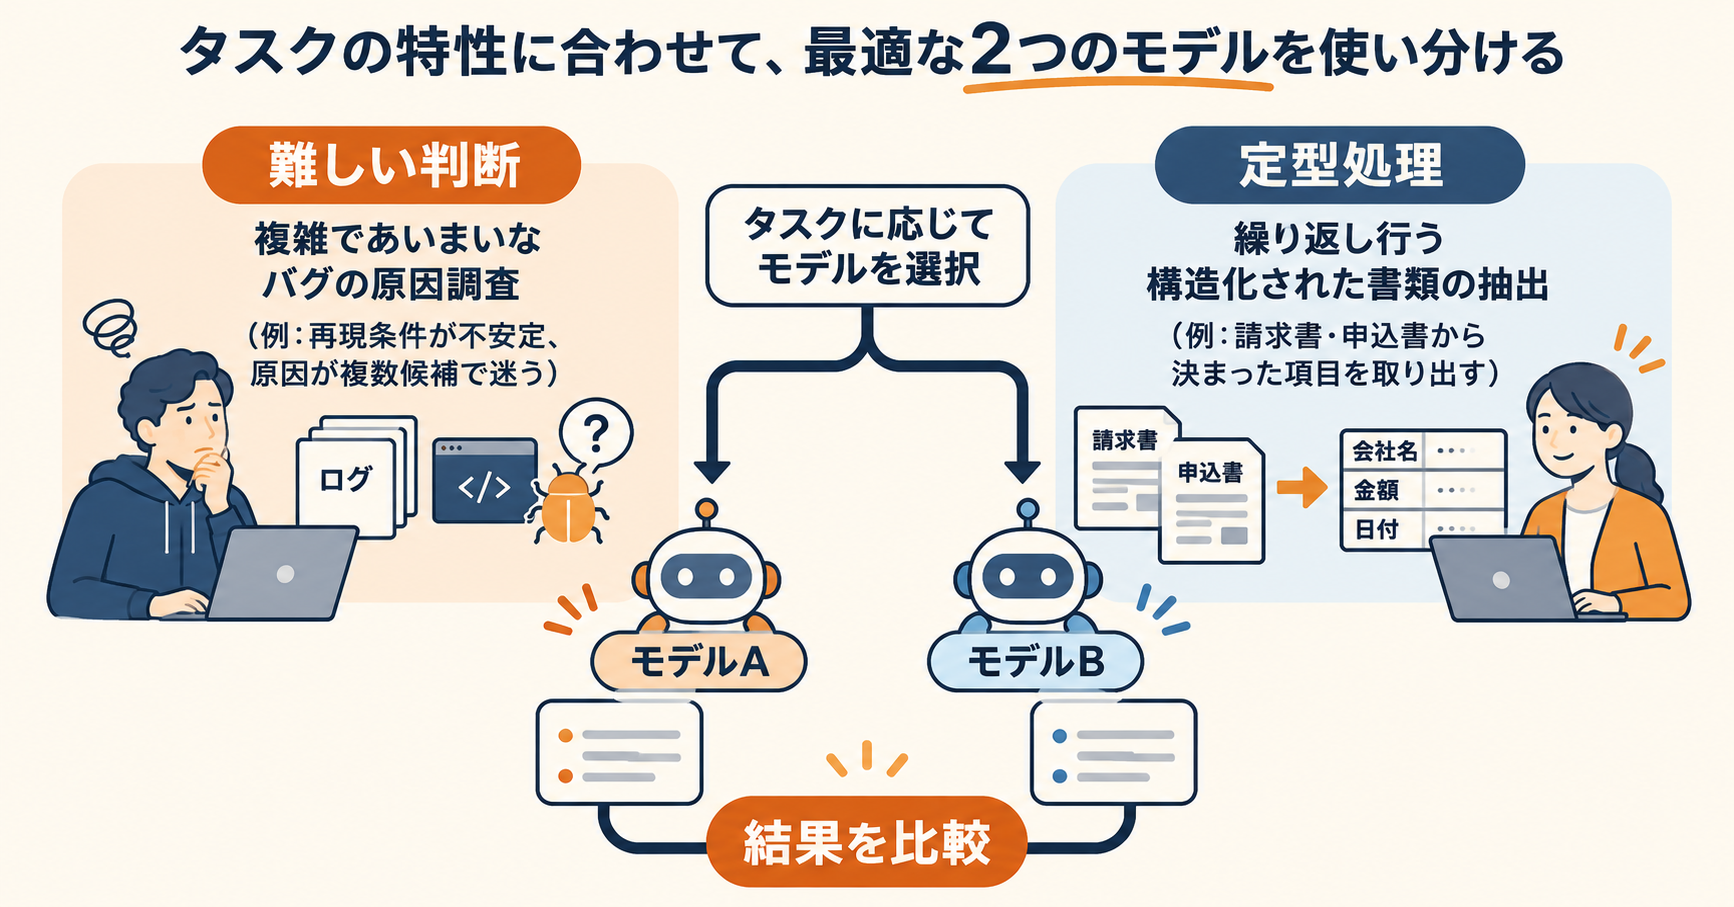
たとえば、発注書から取引先、商品番号、個数、納期を抜き出す仕事では、元の欄と出力を照合して正誤を判定しやすい。対して、複数の業務システムにまたがる不具合を調べる仕事では、どの証拠を先に探すか、修正が別の機能を壊さないかまで考える。求める出力の種類が異なるので、最初から同じモデル・同じ推論量で全件を処理すると、簡単な仕事に費用を掛けすぎたり、難しい例外を見逃したりする可能性がある。
公式ガイドはAstraを要求の厳しいタスク、Solを低い費用で複雑な仕事を行う用途に位置づける。これは導入時の候補を絞る情報になるが、自社の注文書や日本語の略称で同じ優劣になるかは別途測る。公表されたベンチマークの順位を、そのまま自社の正答率や社員の削減時間に置き換えることはできない。GPT-6.2利用ガイド
過去の仕事を、採点できる単位に切る
導入前の資料には、人がすでに処理を終えた書類を使うと、正解の確認に役立つ。ただし、その結果をモデルへ一緒に渡すと、自力で項目を見つけたかを測れない。入力資料と採点用の答えを分け、モデルには業務で実際に得られる情報だけを渡す。個人情報や顧客情報を含む資料では、利用が認められた環境と範囲で扱い、試験の目的に不要な値は省く。
採点は「正しい・誤り」の合計だけでなく、誤りが業務へ及ぼす影響も見る。社名の表記揺れと、振込先や納期の取り違えでは、確認の優先度が異なる。必要な欄が空欄のときに、もっともらしい値を補う出力も採点対象にする。確かめられない項目を未確認と返せれば、人が原本へ戻るきっかけになる。モデルの文章の印象より、こうした例外の扱いが担当者の負担を左右する。
API単価と「仕事1件の費用」を分けて計算する
11月19日に確認した公式価格表のStandard料金では、100万トークン当たり、Astraは入力8ドル、出力40ドル、キャッシュ済み入力0.40ドル。Solは入力2ドル、出力10ドル、キャッシュ済み入力0.10ドルだ。API料金の比較では、速度の区分や処理方式も揃える。ChatGPTの定額プランでの利用枠は、APIの従量料金とは契約の単位が異なるため、APIの価格表だけで月の契約費を説明しない。公式API価格表
同じトークン量ならどうなるか
以下は編集部による仮定の計算だ。1件に入力1万トークン、出力2千トークンを使い、キャッシュを使わず、追加ツール費用も発生しないとする。Astraは入力0.08ドルと出力0.08ドルで合計0.16ドル、Solは入力0.02ドルと出力0.02ドルで合計0.04ドルになる。同じ条件で100件なら16ドルと4ドルだ。これは料金表の算術例で、モデルを実行して計測した費用ではない。
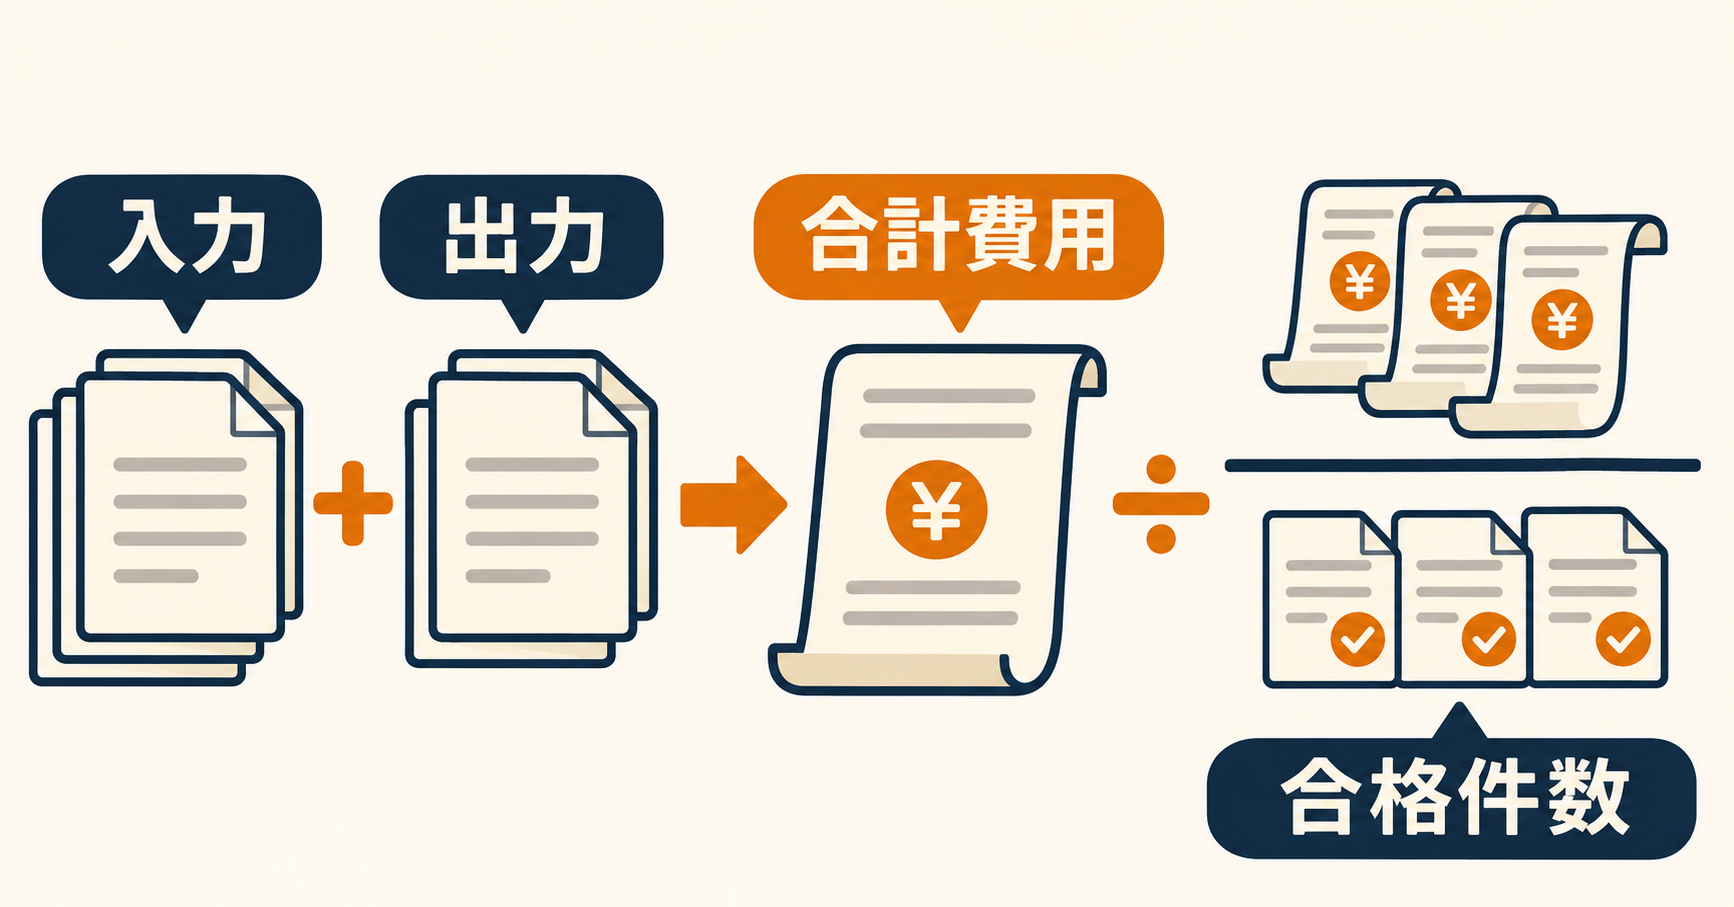
現実の1件では、資料の読み直し、ツールから返る情報、再試行が増える。出力トークンに関する料金の扱いも契約文書で確認する。社内の比較表にはAPIの合計料金と、合格した件数を記録し、合計料金を合格件数で割る。100件を安く処理できても、不備で半数をやり直すなら、担当者が受け取れる1件当たりの費用は増える。処理速度と費用を合わせて見る考え方は小型モデルの仕事の分け方でも扱った。
さらに、人による修正時間は別に記録する。AI出力が短くなってAPI費用が下がっても、必要な説明が抜けて社員が資料を読み直すなら、業務全体の短縮にはつながらない。モデル単体の安さと、完成物を得るまでの費用を同じ欄に混ぜずに把握したい。
例外だけをAstraへ渡す案の試算
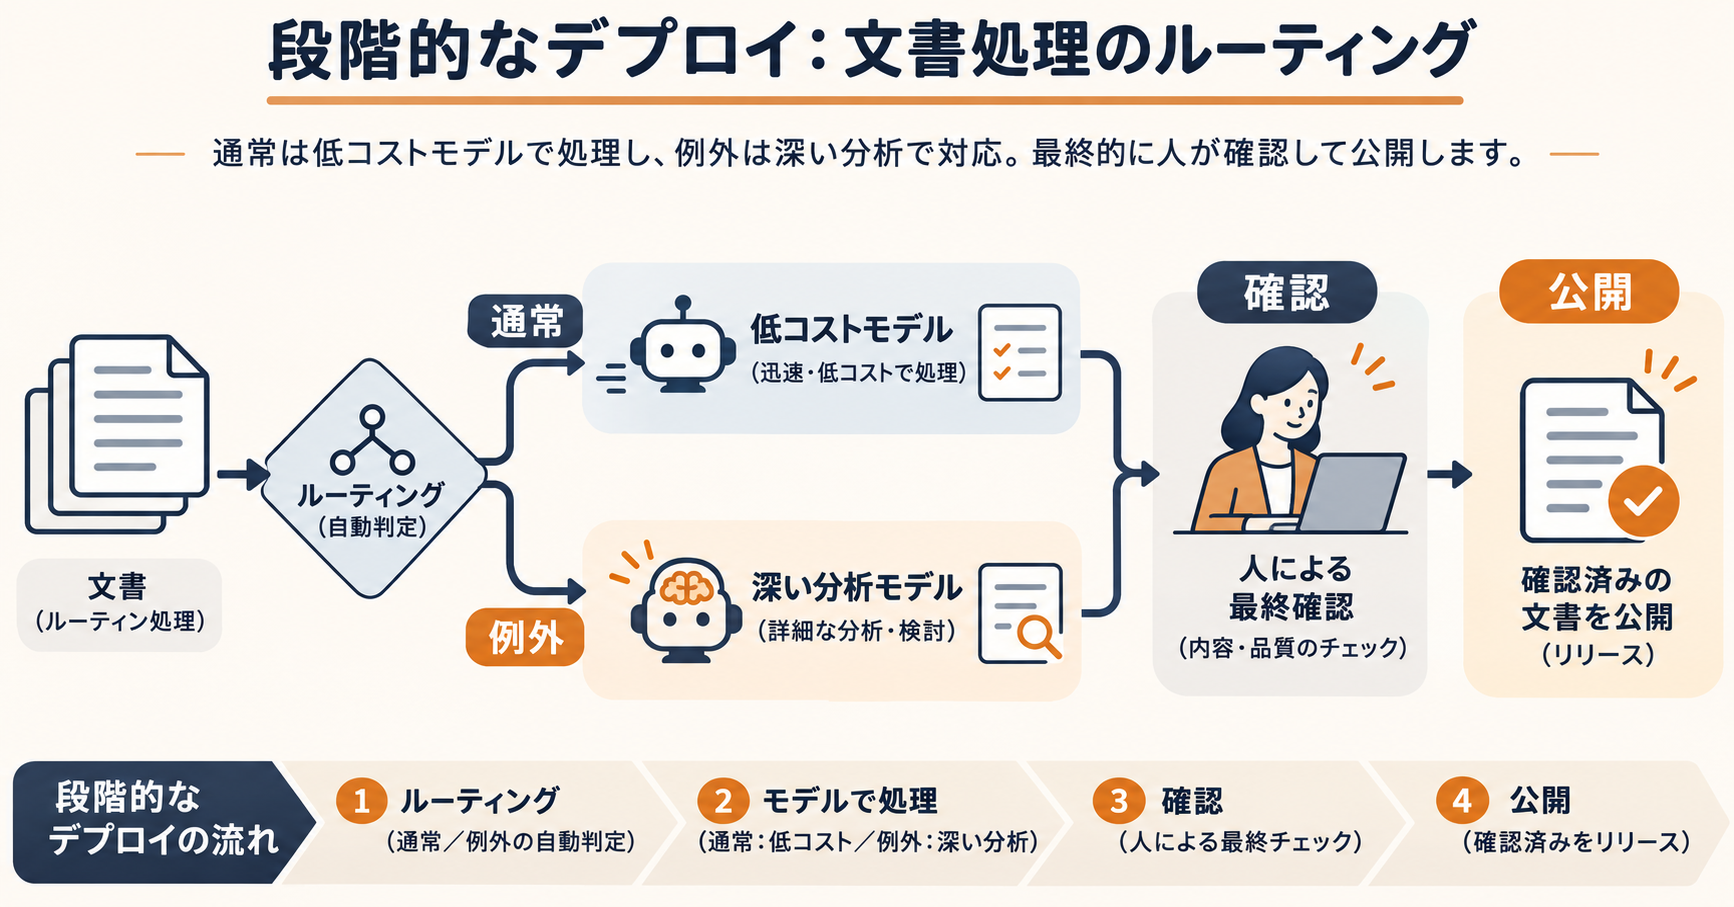
さらに、前述と同じトークン条件で100件をSolに渡し、そのうち20件をAstraで再処理すると仮定する。Solの4ドルにAstraの3.20ドルを加えて7.20ドルになる。全件をAstraで処理する16ドルより小さいが、これは比較用の入力条件を揃えた算術例だ。例外を検出する処理、引き継ぐ説明、追加の検索が必要なら費用は増え、最終的な品質が同じとも限らない。
この案で先に測るべきなのは、Solが苦手だった件を正しく例外へ回せるかだ。誤った答えを自信ありとして通常処理へ通すなら、例外用に高性能モデルを用意しても不備が残る。逆に何でも例外にすると、二重に処理する費用と時間が膨らむ。抽出できなかった必須項目、原本どうしの矛盾など、業務上の条件で振り分ける方法をまず試し、モデルの自己評価だけに頼らず採点する。
費用比較の結論には、対象件数、例外の件数、合格件数、ツール利用の有無を添える。1件だけの成功例を月全体の節約率に広げると、書類の種類が増えたときに予算を外しやすい。通常期と繁忙期に入力の量や質が変わる業務では、期間を分けて記録する。
同じ資料で比べ、失敗した仕事も評価に残す
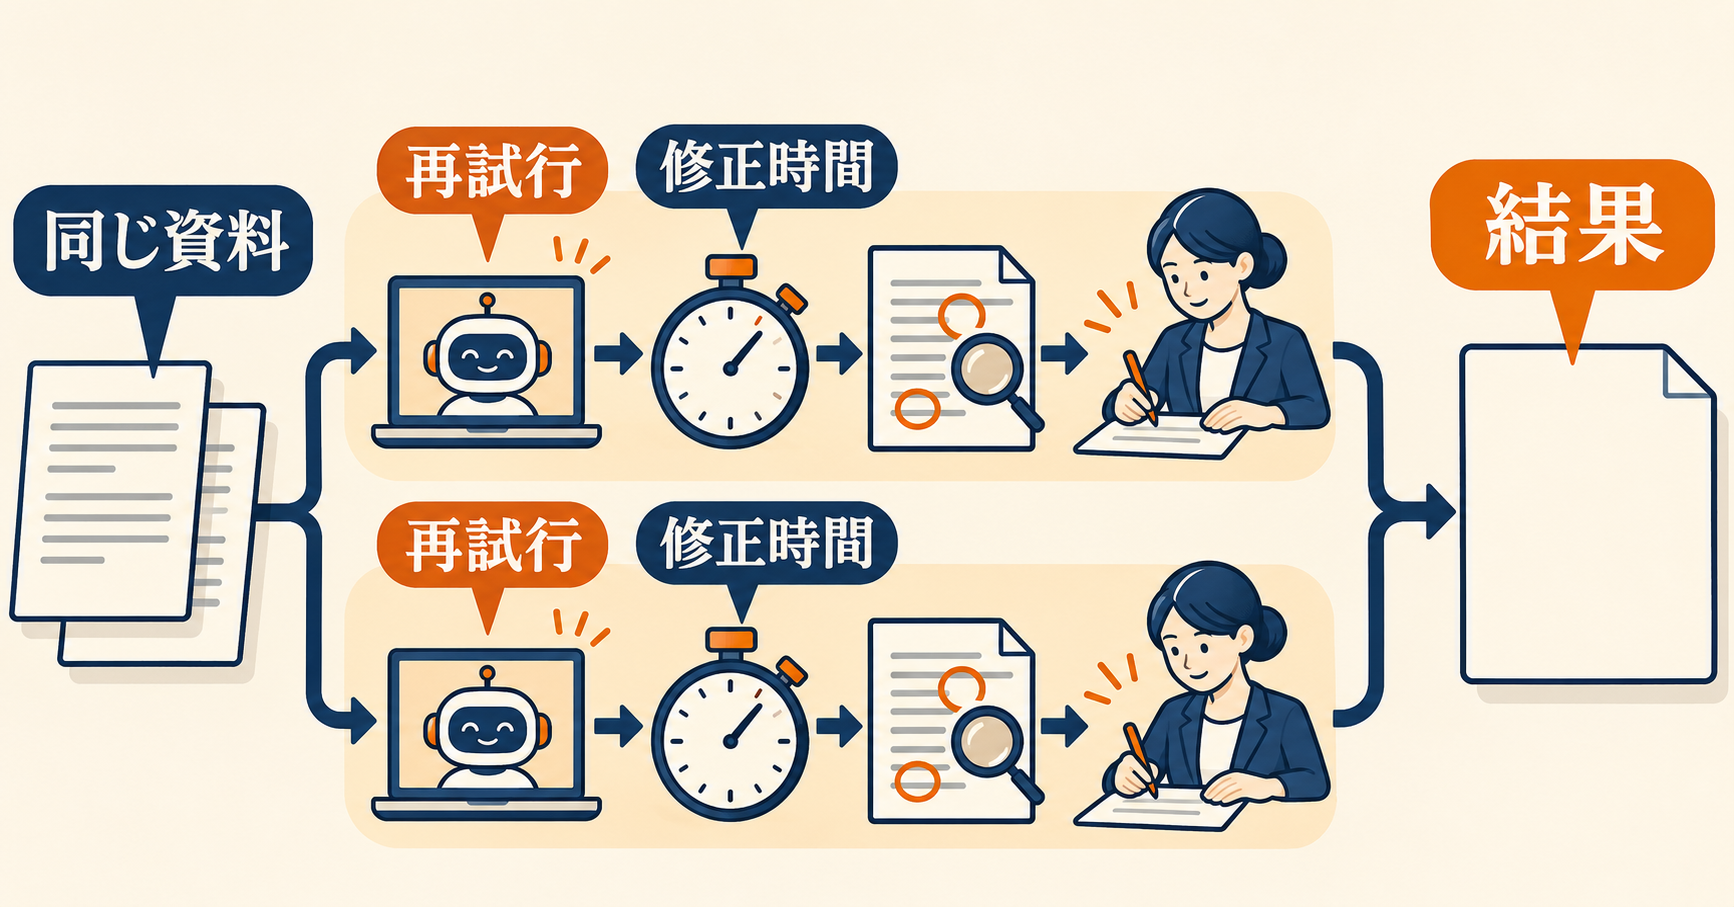
比較を始める前に、合格条件を決める。発注書の抽出なら必須項目の欠落、番号の転記ミス、数量と単価の混同を別々に数える。調査レポートなら、根拠にした文書を開けるか、数値が対象期間と一致するか、結論が資料の範囲に収まっているかを確認する。きれいな文章であることと、業務に使えることを分けて採点する。AIモデルの評価とプロンプト依存
比較結果を歪めないための記録
編集部が提案する試験では、同じ資料、同じツール権限、同じ完了条件を使い、モデル名と設定を固定して比較する。処理時間、API利用量、再試行回数、人が直した時間、未完了の理由を残す。難しい書類を片方にだけ渡したり、成功した出力だけを比較したりすると、実務でどちらを使うべきか判断しにくい。通常例だけでなく、番号のない書類や資料間の矛盾も同じ組に入れる。
OpenAIのシステムカードは、能力とともに安全性の評価条件や限界を公開している。評価対象の仕事、利用した道具、制御の条件を読めば、実際の利用環境に適用できる範囲を考えやすい。業務での不備を確認するときも「回答が出たか」に加え、必要な作業を終えたか、途中の障害が明示されたかを調べる。試験を通った範囲を記録し、結果が曖昧な用途まで一括で許可しない。GPT-6.2システムカード
失敗の記録はモデル選びだけでなく、資料の置き方の改善にも使える。両モデルが同じ項目を取り違えるなら、書類の命名、参照先、注文番号の位置が不明瞭なのかもしれない。モデルを切り替える前に入力側を直して再試験すれば、問題がモデル固有か、業務資料の構造にあるかを切り分けられる。これは公表された性能の追加主張ではなく、比較試験の設計上の考察だ。
レポートの評価では、結論の根拠までたどる
生成されたレポートなら、リンクがあるだけで合格にしない。対象の文書を開き、引用した数字、対象期間、調査方法が本文と対応するかを見る。たとえば企業全体の売上を一つの製品の売上として記していれば、文章として滑らかでも判断材料には使えない。資料が確認できない場合に、その不足を明示しているかも調べる。
比較の結果を「Astraは優秀」「Solは速い」という一言にまとめず、どの種類の仕事で、どの条件なら採用できたかを書く。得意な範囲と失敗の種類が分かれば、モデルの追加や更新があった際にも同じ試験を使える。社内のノウハウとして残るのは、選んだモデル名だけでなく、仕事の合格条件と採点の記録だ。
移行は例外の引き継ぎと会話履歴の扱いまで確かめる
既存のAPI連携を置き換える場合、モデル名を変更するだけで同じ振る舞いが続くとは限らない。公式移行ガイドは、GPT-6.2では会話の途中で以前の指示や履歴を書き換えると、推論項目が引き継がれなくなり、再検討でトークンが増える場合があると説明している。繰り返し使う指示は先頭に置き、新しい資料や今回の依頼を後ろへ追加する構成を確認する。
たとえば書類Aの処理を終えて書類Bへ進むたびに、過去のメッセージを毎回組み直す実装なら、キャッシュの利用や会話の継続に影響する可能性がある。評価では単発の1回だけでなく、通常の入口から複数回続けて実行する。キャッシュ済み入力の割安な単価を試算に使う場合も、実際にどの入力がキャッシュ対象になったかを利用記録で確認してから費用に反映する。
小規模なチームが採用を決める条件
最初は一つの業務で、通常処理をSol、根拠が食い違う例外をAstraなど、候補となる分担を試す。例外を渡すときは、元の資料、処理済みの箇所、未確認の項目を含める。引き継ぎだけで元資料が失われるなら、最初からやり直す時間が増える。人の最終確認で不備を検出できない、費用の記録が取れない、以前のモデルに戻したときに状態が壊れる場合は、適用範囲を広げる前にその工程を直す。
公開や送信など、外部に結果が反映される業務では、試験用データでの検証に成功した後も、保存・反映・再取得の工程を含めて確かめる。原稿が完成していても配信先へ届かなければ、業務上は未完了になる。担当者は、ファイルを作った時刻と、公開先で確認できた時刻を区別して記録する。失敗した処理を再実行する場合も、同じ内容を重複して送らないかを確認する。
本稿で行ったのは、公式資料の照合と、上記の仮定に基づく料金計算だ。APIへの課金を伴う比較実行は行っておらず、日本語の実案件における両モデルの正答率や所要時間は測定していない。導入判断では、この区別を保ったうえで自社の合格条件に沿った結果を集める必要がある。
本メディアはRO合同会社が運営する。題材の参考はイノベトピアのGPT-6.2記事。出典は本文中の公式発表、価格表、利用ガイド、システムカード。提供状況の補足にはOpenAIのモデルリリースノートを確認した。
PR
ElevenLabs →