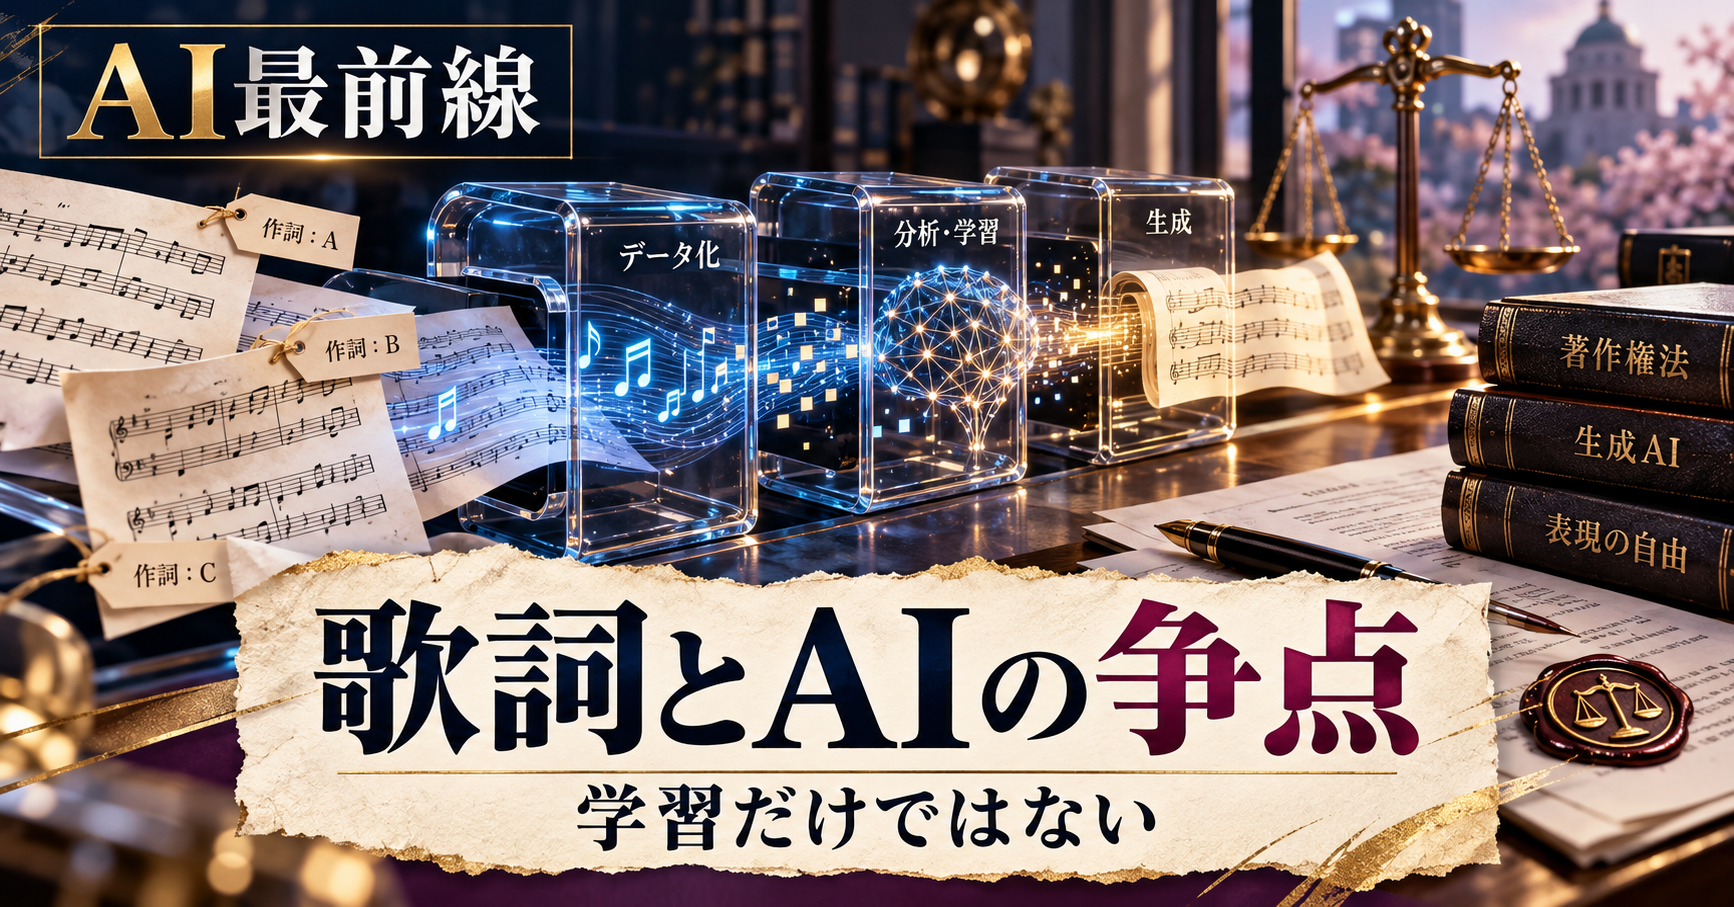
ソニー、ワーナー系の音楽出版社がAnthropicと共同創業者を提訴した問題は、「AIは音楽を学習してよいか」という一問だけでは整理できない。楽曲を集める経路、テキストの加工、モデルへの取り込み、利用者への歌詞の出力という複数の行為が争われている。訴状を工程に分けて読むと、企業がAI向けデータを調達する際の確認点も見えてくる。
出版社の請求と、裁判所の判断を分ける
2026年8月28日付の訴状では、Sony Music PublishingやWarner Chappellの関連会社など35の原告が、Anthropic PBC、Dario Amodei氏、Benjamin Mann氏を被告としている。カリフォルニア北部地区連邦地裁の事件番号は5:26-cv-09217だ。本稿が扱うのは、この提出書面に記された原告の主張であり、侵害が認定されたとの報告ではない。
ここで中心になるのは、楽曲の歌詞や作曲に関する音楽出版社側の権利である。歌手の録音そのものを保有するレコード会社の原盤権とは区別する必要がある。また、争点を音楽生成サービスだけに限定するのも適切ではない。文章で対話するAIが歌詞を学習し、回答に再現する問題も含まれる。
原告が違法な複製や権利管理情報の除去を訴えていることと、その法的要件が証拠により満たされることは別の段階だ。損害の主張も、そのまま確定した市場損失ではない。提訴時点の書面から、賠償額や責任の帰結まで先取りすることはできない。
学習データの入口から、問題は始まる
訴状は、海賊版書籍の集積サイトを含む経路から作品が収集されたと主張する。歌詞が掲載された書籍やウェブページを大量のテキストへ変換し、モデルの開発に利用したという筋立てだ。重要なのは、「学習に使った」という目的だけで、作品の入手方法の問題まで解決するわけではない点である。
取得段階では、誰が何を配布し、そのコピーを受け取る権限があったかが問われる。学習段階では、複製の目的や変容性、利用量、市場への影響などが争われうる。出力段階では、保護対象の表現がどれほど再現されたかという別の確認が必要になる。同じシステムの中でも、各行為で必要な事実は異なる。
企業実務であれば、データセットの名称だけを記録するのでは足りない。取得元のURL、取得時の許諾条件、提供者の権限、対象作品、加工履歴を追跡できることが重要になる。第三者が「公開データ」と説明していても、閲覧できることと、あらゆる用途へ複製できることは同義ではない。
テキスト抽出で失われるクレジット
もう一つの柱が、著作権管理情報、英語でCMIと呼ばれる情報の扱いだ。作品や著作者を示す表示、著作権者の情報などは、権利を確認し、利用条件へ到達する手がかりになる。原告は、こうした情報が前処理の過程で取り除かれたと主張している。
訴状には、ウェブページから本文を取り出すNewspaper、Readability、jusTextなどのツールが登場する。原告は、ページのフッターなどに含まれる著作権表示を除く性能と、ツールの選択に関するやり取りを結び付けている。これは単なる抽出精度の比較としてだけでなく、どの情報を落とすことを意図したかという問題として提出されている。
ただし、HTMLの不要部分を削る処理がすべて自動的に違法になるわけではない。米国著作権法1202条は、無断除去などの行為に加え、侵害を誘発・可能化・促進・隠蔽すると知っている、または知る合理的理由があるといった要件を定める。どの表示が対象の情報か、誰がどの目的で処理を決めたかを具体的に検討する必要がある。
データ整形では、本文を読みやすくする処理と、権利情報を別のメタデータとして保存する処理を両立できる。表示を学習入力から外す必要がある場合でも、出所まで消す設計にする必然性はない。取得時の情報を別管理し、データ単位でたどれるようにすることが、後の説明や削除対応を支える。
共同創業者が被告になった意味
会社だけでなく共同創業者個人を被告に含めた点も、この訴訟の特徴である。訴状は、データ収集や処理の方針、開発上の意思決定への関与を責任の根拠として挙げている。役職に就いているだけで個人責任が確定するという話ではなく、特定の行為への関与や認識を原告が問題にしている。
この点を、日本のAI導入企業にそのまま当てはめることはできない。一方、誰が利用条件を確認し、誰が例外を承認し、懸念をどう共有したかという記録の価値は共通する。技術部門だけでデータを受け取り、法務部門が完成後に初めて知る流れでは、取得や前処理の問題を修正しにくい。
承認を形式的なチェック欄にせず、対象データと用途を特定することが必要だ。研究用に許されたデータを商用モデルへ移す、社内検索用に受け取った文書を追加学習へ流すといった変更は、当初の確認範囲を越える可能性がある。用途が変わった時点で再確認できる仕組みが求められる。
フェアユースだけでは説明しきれない
米国のAI著作権訴訟ではフェアユースが注目される。しかし、その判断は特定の作品、利用行為、証拠に即して行われる。別件で学習の適法性について判断が出ても、今回の取得経路や権利管理情報、歌詞の出力に関する争いが一括して決まるわけではない。
音楽出版社側が懸念するライセンス市場への影響と、AI開発側が述べる学習の性質も、対立する評価として読む必要がある。利用者の質問へ応じるために作品の表現をそのまま返すことと、作品に関する事実を説明することは、回答設計上も分けられる。歌詞の全文再現を抑える運用だけで取得時の問題が解消するわけではないが、出力に関する別の対策としては意味を持つ。
日本の事業者が得られる実務上の示唆は、データの入口、加工、学習、出力の各段階に確認責任を置くことだ。出所が不明なデータは混ぜる前に止め、権利情報は追跡可能に保ち、出力側には再現テストや申立てへの対応経路を設ける。これらは裁判の結論を予想することより、自社が説明できる利用の範囲を明確にするための作業である。
本件を題材に、社内データの出所管理やAI導入時の確認工程を整理したい場合は、運営会社のRO合同会社の公式サイトをご覧ください。
出典:音楽出版社側の2026年8月28日付訴状、米国著作権法1202条、取材の起点となったイノベトピア記事。訴状の主張と裁判所の認定を区別して構成しています。
ポッドキャスト燎RYOU課 ポッドキャスト
ポッドキャストを聴く →