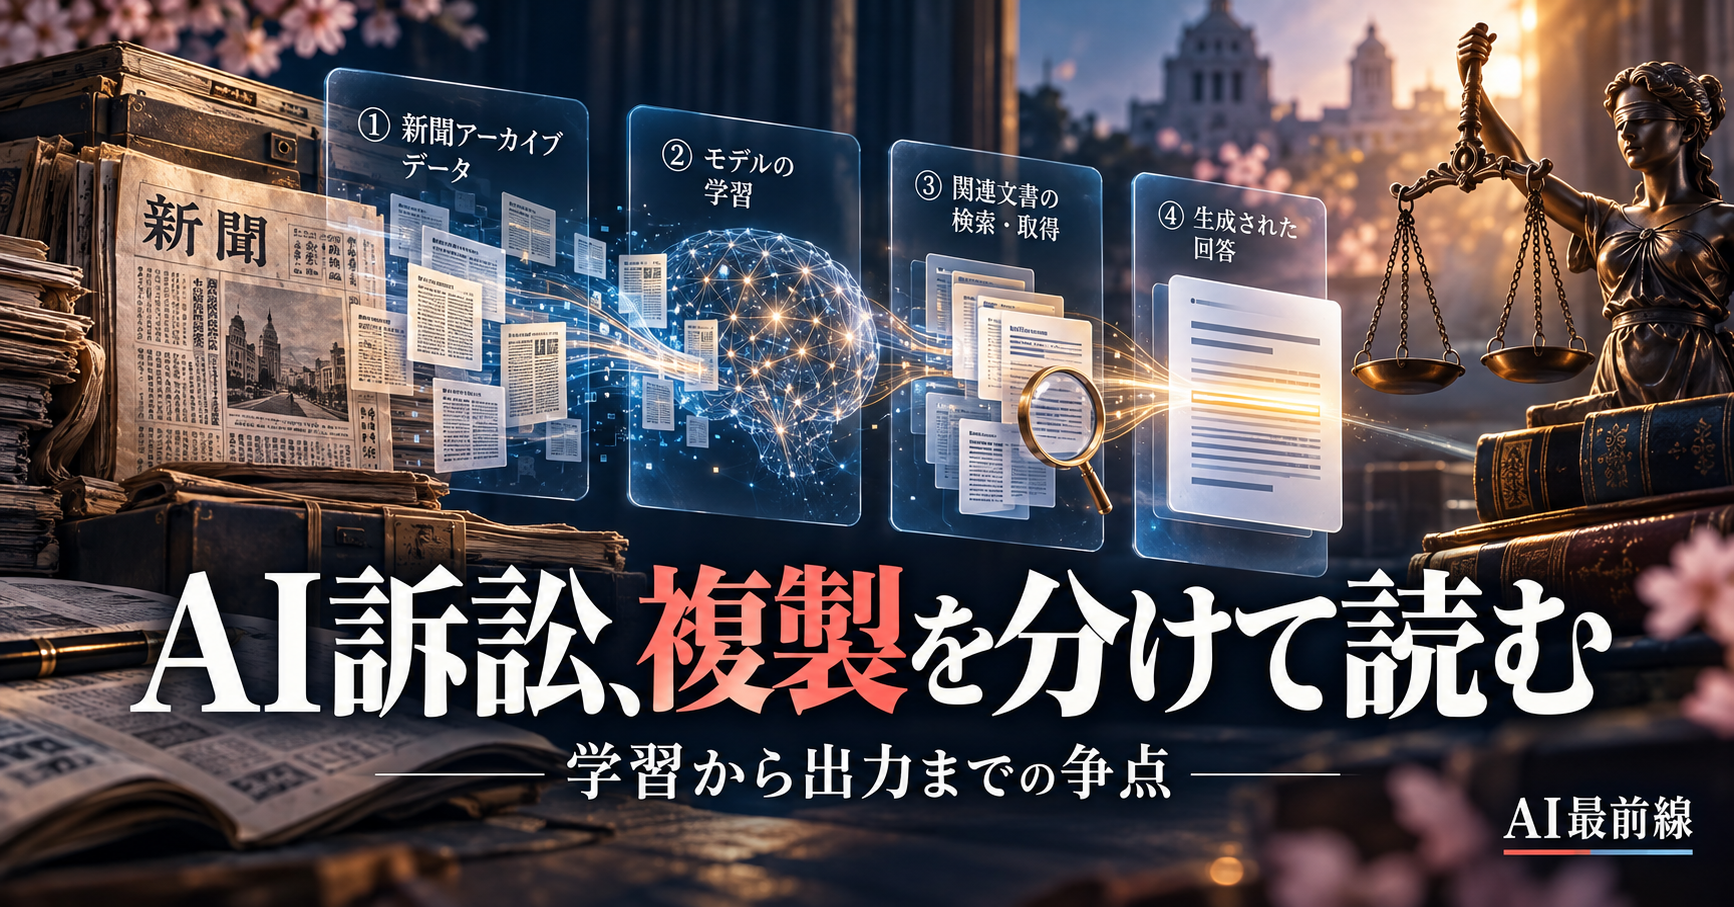
生成AIをめぐる著作権の議論では、「学習に使った」という一言の中へ、データの取得、保存、検索、回答、他社への提供までが混ざりやすい。報道各社がOpenAIとMicrosoftを訴えた米国の訴訟で公開された原告側の書面は、これらを段階ごとに切り分けて主張している。
今回確認したのは、2026年9月17日に提出された原告側の略式判決に関するブリーフの公開版だ。黒塗りが一部外れ、社内文書や証言からの引用が増えている。ただし、これは裁判所の判決ではなく、一方の当事者が自らの主張を支えるために構成した資料である。公開ブリーフPDF
最初に、書面の立場を確認する
社内メールや証言の強い表現は、ニュースの見出しになりやすい。しかし、一人の従業員の発言が、そのまま会社全体の法的な認識や裁判所の判断になるわけではない。引用された前後の文脈と、証拠として何を示そうとしているかを分けて読む必要がある。
また、公開ブリーフが読めることと、引用元の証拠をすべて独立に検証できることは同じではない。公開版にも黒塗りが残り、根拠となる証拠の全体が公開されているわけではない。今回の記事では「原告はこう主張する」「書面にこう記される」という範囲を明示する。
生成AIの合法性を一括して決める資料としてではなく、具体的な行為のどこが争われているかを知る資料として読むと、実務にもつながる。特に取得したデータを何のために使い、誰へ渡し、どこへ表示したかという違いが重要になる。
原告が分けた五つの行為
書面の構成には、取得、学習、グラウンディング、出力、そしてhorse tradingという分類がある。グラウンディングは、回答を生成する際に外部の資料を取得し、根拠として使う工程を指す。horse tradingの部分では、企業間でデータを受け渡したとする主張が扱われている。
取得の論点は、どの経路から、どの条件でコンテンツを手に入れたかだ。公開ウェブに置かれている資料、利用条件が付いたアーカイブ、アクセスを制限する仕組みのあるサイトでは、確認する事項が異なる。後で何に使うかだけでなく、手に入れる段階の条件を読む必要がある。
学習の論点は、取得した複製がモデルを訓練するためにどう使われたかとなる。書面は、中間学習データセットに原告作品の複製が91,692件を超えて含まれると主張する。ただし、件数の提示だけで、対象となる利用すべての法的な結論が決まるわけではない。
グラウンディングと出力は、モデルの訓練が済んだ後の利用にも関わる。検索で取った記事を回答の材料にすることと、その回答が原文の表現をどれだけ含むかは、異なる問いだ。学習段階についての説明だけでは、検索時の複製や実際の出力を十分に説明したことにならない。
他社へ渡す工程は、学習と同一ではない
企業間のデータの受け渡しについて、書面はOpenAIとMicrosoftの取引や共同作業を取り上げる。Project Taxi、Project Mangoなどの名前とともに、Bing由来のデータや学習用のデータセットの提供が記される。Mango由来のデータセットには、原告のユニークな著作物が160,903件以上含まれると原告は主張する。
この分類の意味は、ある会社が自分のモデルを学習させることと、別会社へコンテンツの複製を渡すことを区別する点にある。学習が終わった後の提供や、製品への組み込みの検討に使う場合には、目的と行為の関係が変わる。すべてを「AI学習のため」と一括すれば、説明できない工程が残る可能性がある。
企業のデータ管理でも同様の切り分けが役立つ。取得した資料を社内だけで解析するのか、外部のモデル提供者へ送るのか、委託先へ渡すのかで、契約と情報管理の条件が変わる。保存先と送信先を記録することは、著作権だけでなく機密管理の観点からも意味がある。
数字が示す市場影響を、測定範囲から読む
原告は、生成AIの回答が記事を読む代わりになり、出版社へ戻る流入を減らすと主張する。書面が示す例では、Times系サイトへのクリック率について、Bing Chatと通常のBing検索を比べた減少幅が87〜93%とされる。これは原告が提示する特定のデータと比較条件の話であり、全ウェブサイトの流入が一律にその割合で減ったという意味ではない。
クリック率は、表示や会話に対してどれだけリンクが押されたかという割合であり、流入数や売上そのものとは違う。対象期間、ユーザー、回答形式、検索の意図が違えば、比較の意味も変わる。強い数値ほど、何の分母で測ったものかを確認する必要がある。
それでも、回答内にリンクを表示したことだけで、出版社への経済的な還元を十分に説明できるとは限らないという問いは残る。利用者が答えだけで目的を達成すれば、リンクがあっても移動しない場合がある。出典を示すことと、元の記事へ読者を送ることは、別々に測るべき性質だ。
編集部の考察として、自社メディアでも参照リンクのクリック、実際の滞在、会員登録や問い合わせまでの経路を分けて追う価値がある。表示回数だけでは、記事が読者との関係を作れているかが分からないためだ。AI検索への対応も、一つの順位指標だけでは評価しきれない。
フェアユースの議論を、すべての工程へ広げない
米国のフェアユースは、利用目的、著作物の性質、利用した量、市場への影響などを具体的に検討する枠組みだ。原告側は、全文の複製や、原文に近い出力、ライセンス市場への影響を、自らの主張に沿って配置している。被告側の主張と裁判所の判断を併せて見なければ、法的な結論は確定しない。
ある工程の目的が変革的だと主張されても、その前後にある取得や配布まで自動的に同じ評価になるわけではない。今回の書面を読む実務上の意義は、AIを使ったかどうかだけでなく、個々の複製や提供を説明する必要があると分かる点にある。
また、権利者情報の削除に関する主張も、学習利用そのものとは別の論点として記される。著者名、出典、利用条件などの情報を、前処理の都合だけで失っていないかは、データの来歴管理にも関係する。後から説明を求められたときに、元の条件へ戻れる状態を保つことが重要になる。
日本のAI利用では、取得条件と出力を別に点検する
日本では著作権法第30条の4が、非享受目的の利用に関する枠組みを設ける。ただし、米国のフェアユースの結論をそのまま日本へ移すことも、日本の条文を根拠にあらゆる取得・生成・公開を一括して認めることもできない。文化庁の整理も、利用の目的や権利者の利益への影響などを考える材料となる。文化庁:AIと著作権
企業が外部データを使う場合には、取得先、利用規約、取得日、利用目的、加工内容、提供先を記録する方法がある。AIへ入力した資料と、出力を公開する際に参照した資料を区別すれば、何を根拠にどの文章を書いたかを確認しやすい。学習用の権限と、社外公開用の権限を同じ欄にしないことも重要だ。
記事を制作する場合は、事実を調べ直し、自分の論点と構成で書き、必要な出典へリンクする。出典を書けば他人の表現を大量に複製してよいということではない。原文と似た言い回しを機械的に置き換えるだけではなく、事実の確認と独自の分析を行う工程が必要になる。
訴訟の進展と、運用上の改善を分けて進める
この書面だけでOpenAIやMicrosoftの責任が確定したとはいえない。今後の反論や証拠、裁判所の判断によって、認められる事実と法的な評価は変わり得る。判決ではない資料を、既に違法と決まった証拠として紹介することは避けたい。
一方、事業者が来歴の記録を整えるために、訴訟の最終結論を待つ必要はない。どこから取得し、何に使い、誰へ渡し、何を公開したかを説明できれば、権利や契約の確認も進めやすい。生成AIの用途が増えるほど、取得から出力までを別々に見渡す運用の価値は大きくなる。
AI活用における資料の扱い、出典管理、公開前の確認工程については、運営会社のRO合同会社へ相談いただける。
参考報道:イノベトピアの元記事。確認日:2026年10月20日。件数やクリック率は原告側書面の主張として記載し、裁判所の認定や一般的な予測値とは区別した。
ポッドキャスト燎RYOU課 ポッドキャスト
ポッドキャストを聴く →